Airflow를 쿠버네티스에 올리기: KubernetesExecutor, git-sync DAG 배포, 재시도·catchup부터 스케줄러 장애와 3.4 업그레이드까지 kind 실습
Airflow가 무엇을 하는지 주문 집계 예시로 먼저 정리하고, 공식 Helm 차트로 올린 뒤 재시도, 동시 실행 한도, 밀린 실행, 스케줄러·DB 장애, 3.2 → 3.4 업그레이드까지 직접 부딪혀 본 기록
로컬 쿠버네티스 실습 시리즈 목차 · 글 15개
- 1편Windows에서 무료 쿠버네티스 실습 환경 만들기: WSL2 + Docker Engine + kind
- 2편Headlamp 설치와 사용법: 로컬 쿠버네티스를 화면으로 보고 파드 배포하기
- 3편NGINX Ingress 대신 Gateway API: kind 클러스터 앱을 Windows localhost로 접속하기
- 4편kube-prometheus-stack 설치와 Grafana 접속: kind 클러스터 모니터링과 target down 해결
- 5편Fluent Bit과 Loki로 쿠버네티스 로그 모으기: kind 실습과 Grafana 조회, AWS 확장 예시
- 6편cert-manager로 Gateway API HTTPS 붙이기: 사설 CA, 자동 갱신, 만료 알림까지 kind 실습
- 7편Keycloak 운영 모드로 Grafana SSO 만들기: Keycloak Operator, CloudNativePG, 이중화와 장애·백업 훈련
- 8편OpenTelemetry로 쿠버네티스 트레이스 모으기: Collector, Tempo, 샘플링과 장애 훈련까지 kind 실습
- 9편Argo CD로 쿠버네티스 GitOps 전환하기: Helm 설치 넘겨받기, Sealed Secrets, Keycloak SSO와 장애 훈련까지 kind 실습
- 부록Argo CD로 nginx 파드 하나 배포하기: GitHub에서 파일 두 개 커밋하고 replicas 바꿔 보기
- 10편Trivy Operator로 쿠버네티스 취약점 점검하기: 이미지·설정·비밀값 스캔, Grafana 경보, Argo CD로 고치기까지 kind 실습
- 번외편Trivy로 찾은 컨테이너 이미지 취약점 고치기: nginx apk upgrade, Go 의존성 올리기, Grafana처럼 직접 못 고치는 경우까지
- 11편Istio Ambient 모드로 서비스 메시 붙이기: 사이드카 없이 mTLS, 권한 정책, waypoint 트래픽 분할과 장애 훈련까지 kind 실습
- 12편Strimzi로 쿠버네티스에 Kafka 올리기: KRaft 브로커 3대, SCRAM·ACL, 소비 지연 경보와 장애·업그레이드 훈련까지 kind 실습
- 13편Airflow를 쿠버네티스에 올리기: KubernetesExecutor, git-sync DAG 배포, 재시도·catchup부터 스케줄러 장애와 3.4 업그레이드까지 kind 실습
Airflow는 “매일 새벽 2시에 주문을 모아 집계하고, 끝나면 리포트를 만들고, 실패하면 다시 시도한다” 같은 작업 묶음을 코드(DAG)로 적어 두면, 정해진 시간에 순서대로 실행하고 결과를 기록해 주는 작업 스케줄러입니다. 이번 편에서는 9편까지 만든 클러스터에 공식 Helm 차트로 Airflow 3.2.2를 Argo CD로 설치했습니다. 작업마다 파드가 하나씩 뜨는 KubernetesExecutor, Git에서 DAG를 받아 오는 git-sync, CloudNativePG로 만든 DB를 썼습니다. 그다음 재시도, 동시 실행 한도, 밀린 실행(catchup), 스케줄러와 DB 장애, 3.4.0 업그레이드를 시험했습니다. 그 과정에서 3.2.2의 스케줄러 버그와, 업그레이드 중에 일을 끝낸 작업이 실패로 기록되는 함정을 만났습니다.
1~12편에서 만든 kind 클러스터(노드 3개, kube-prometheus-stack, Fluent Bit·Loki, CloudNativePG, Envoy Gateway, Argo CD로 Git 관리)를 이어서 씁니다. Airflow 공식 Helm 차트 1.22.0으로 Airflow 3.2.2를 설치하고, 훈련에서 3.4.0으로 올렸습니다. 로그인은 SSO 없이 관리자 비밀번호로만 했고, 작업 로그는 별도 저장소 없이 기존 Loki로 모았습니다. 12편 Kafka와의 연결은 다음 단계에서 다룹니다.
Airflow는 무엇을 하나: 매일 새벽 주문 집계로 보기
쇼핑몰에서 매일 새벽에 전날 주문을 모아 집계하고, 그 결과로 리포트를 만들어 담당자에게 보낸다고 해 봅시다. 가장 간단한 방법은 서버 한 대에 cron을 걸어 두는 것입니다.
# cron으로 하면: 시간만 맞춰 스크립트를 실행한다0 2 * * * /opt/jobs/extract_orders.sh30 2 * * * /opt/jobs/make_report.sh # 추출이 끝났다고 "가정"하고 30분 뒤에0 3 * * * /opt/jobs/send_report.sh작은 일에는 이것으로 충분합니다. 그런데 추출이 평소보다 오래 걸려 30분을 넘기면, 리포트는 반쯤 모인 데이터로 만들어집니다. 추출이 실패해도 뒤 작업은 그대로 돌고, 어제 몇 시에 무엇이 실패했는지 찾으려면 서버에 들어가 로그를 뒤져야 합니다. 서버가 하루 꺼져 있었다면 그날 집계는 아무도 모르게 빠집니다.
Airflow는 이 작업들을 “순서가 있는 묶음”으로 코드에 적게 합니다. 앞 작업이 성공해야 다음 작업이 돌고, 실패하면 정해진 횟수만큼 다시 시도하고, 모든 실행 기록이 DB와 화면에 남습니다. 빠진 날짜가 있으면 그 구간을 채워 실행할 수도 있습니다.
cron과 Airflow 비교
| 구분 | cron | Airflow |
|---|---|---|
| 순서 | 시간 간격으로 대충 맞춤 | 앞 작업이 성공해야 다음 작업 실행 |
| 실패 처리 | 직접 스크립트에 넣어야 함 | 작업마다 재시도 횟수·간격 지정 |
| 기록 | 서버 로그 파일 | 실행마다 상태·시간·로그가 DB와 화면에 남음 |
| 빠진 실행 | 알 수 없음 | start_date부터 빠진 구간을 채워 실행(catchup) |
| 여러 서버 | 서버마다 따로 | 작업을 여러 워커(쿠버네티스에서는 파드)에 나눠 실행 |
12편 Kafka와는 무엇이 다른가
Kafka는 “결제가 끝났다” 같은 일이 생기는 즉시 메시지를 흘려보내는 통로입니다. Airflow는 “매일 새벽 2시”처럼 정해진 때에, 정해진 순서로 묶음 작업을 돌리는 지휘자입니다. 실무에서는 둘을 함께 써서, Kafka에 쌓인 데이터를 Airflow가 주기적으로 모아 처리하기도 합니다. 이 연결은 다음 단계에서 직접 해 볼 예정입니다.
용어와 구성 요소
Airflow 용어
| 말 | 뜻 | 이번 실습 |
|---|---|---|
| DAG | 작업 묶음과 순서를 적은 파이썬 파일. 방향이 있고 되돌아오지 않는 그래프라는 뜻 | lab_pipeline 등 6개 |
| 태스크 | DAG 안의 작업 하나 | extract, transform, report |
| DAG 실행(DAG run) | DAG를 한 번 돌린 것. 예약 실행과 수동 실행이 있음 | 10분마다 scheduled__… |
| 태스크 인스턴스 | 어떤 실행 안에서 태스크 하나가 돈 기록. 재시도하면 시도 번호가 늘어남 | call_api 시도 1·2·3 |
| executor | 태스크를 어디서 돌릴지 정하는 방식 | KubernetesExecutor: 태스크마다 파드 하나 |
| pool | 여러 DAG가 함께 쓰는 동시 실행 자리 수 | lab_pool 64 → 5 |
| catchup | start_date부터 지금까지 빠진 예약 실행을 채울지 여부 | lab_catchup |
Airflow 3의 구성 요소는 다음과 같습니다. 모두 메타데이터 DB(PostgreSQL)를 중심으로 움직입니다.
Airflow 3 구성 요소
| 구성 요소 | 하는 일 |
|---|---|
| api-server | 웹 화면과 REST API. 작업 파드도 이곳에 상태를 보고함(Execution API) |
| scheduler | 실행할 때가 된 DAG와 태스크를 고르고 executor에 넘김 |
| dag-processor | DAG 파일을 읽어 DB에 등록. Airflow 3부터 항상 따로 뜸 |
| triggerer | 오래 기다리는 작업(센서 등)을 적은 자원으로 대기시킴 |
| 메타데이터 DB | DAG, 실행, 태스크 상태, 연결 정보 저장 |
KubernetesExecutor에서 태스크 하나가 도는 흐름은 이렇습니다. 상시 떠 있는 워커가 없고, 태스크가 있을 때만 파드가 생깁니다.
scheduler: "lab_pipeline.extract를 돌릴 때다" → 쿠버네티스에 파드 생성 요청작업 파드: ① git-sync 초기 컨테이너가 Git에서 DAG 파일을 받음 ② base 컨테이너가 extract 함수 실행, 출력은 표준 출력으로 ③ 결과(성공·실패)를 api-server에 보고scheduler: 결과를 확인하고 파드 삭제 → 다음 태스크 transform의 파드 생성Airflow 3에서는 작업 파드가 DB에 직접 붙지 않고 api-server를 통해 상태를 보고합니다. 이 구조가 업그레이드 훈련에서 중요한 역할을 합니다.
이번 편에서 만드는 구성
13편 구성
| 항목 | 선택 | 이유 |
|---|---|---|
| 설치 | 공식 Helm 차트 1.22.0을 Argo CD로 | 9편 GitOps 그대로 |
| 버전 | 3.2.2로 설치 → 훈련에서 3.4.0 | 차트 기본값으로 시작하고, 차트보다 새 버전으로 올릴 때 생기는 일을 확인 |
| executor | KubernetesExecutor | 작업마다 파드, 상시 워커·Redis 없음 |
| DB | CloudNativePG airflow-db(주 1 + 복제 1) | 7편 운영자 재사용, 장애 전환 시험 가능 |
| DAG 배포 | git-sync로 GitOps 저장소의 airflow-dags 폴더 | DAG도 Git push로 배포 |
| 로그 | 별도 저장소 없이 표준 출력 → 5편 Fluent Bit·Loki | 가장 단순한 방법 |
| 화면 | Envoy Gateway airflow.localhost(HTTPS) + 관리자 비밀번호 | 3·6편 재사용, SSO 없음 |
| 지표·경보 | StatsD 지표 → Prometheus, 경보 4개 | 4편 재사용 |
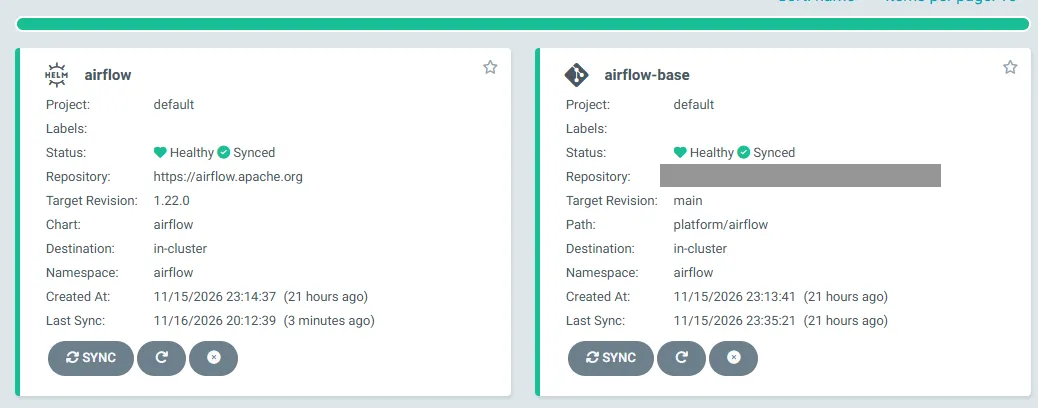
Argo CD Application은 두 개로 나눴습니다. airflow-base(wave 0)가 네임스페이스, DB, 비밀값, 경보를 먼저 만들고, airflow(wave 1)가 Helm 차트를 설치합니다. 화면의 Git 저장소 주소는 가렸습니다.
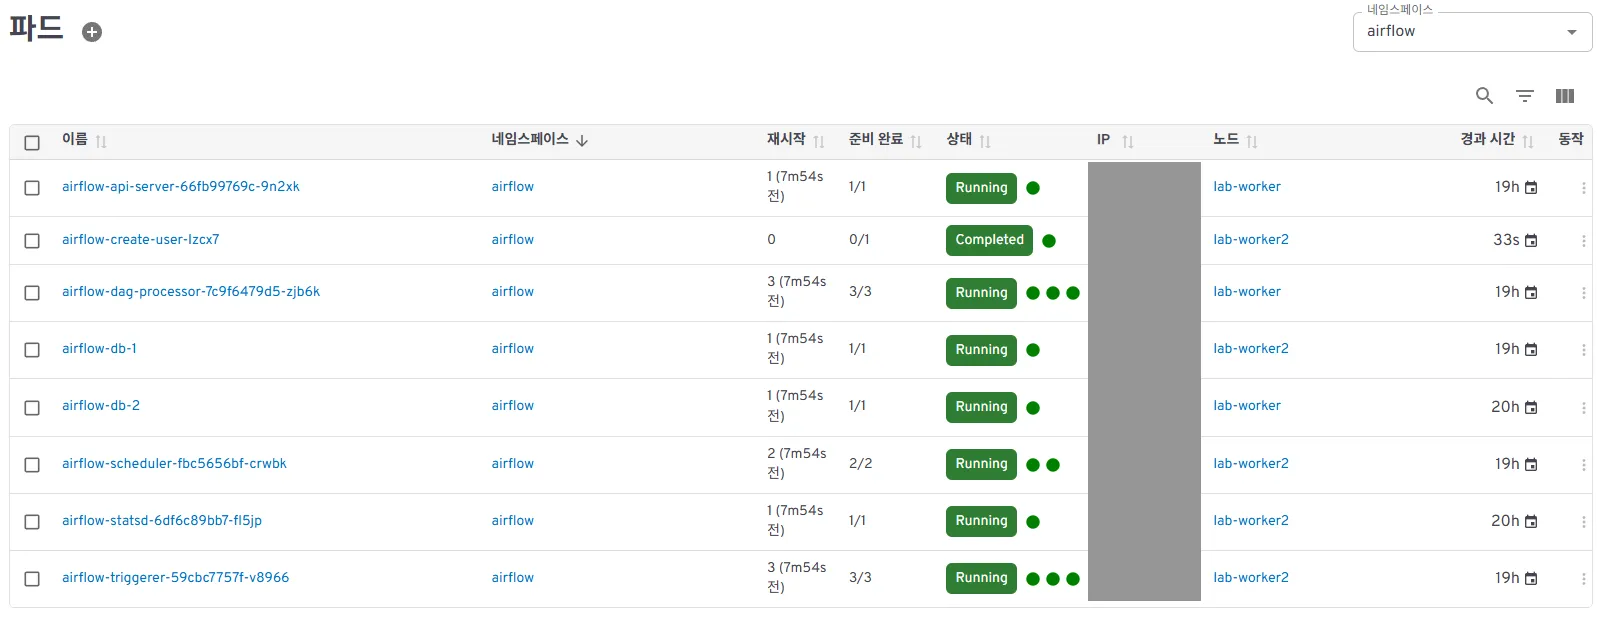
설치가 끝난 airflow 네임스페이스입니다. api-server, scheduler, dag-processor, triggerer, statsd와 DB 2개가 상시 떠 있고, 작업 파드는 태스크가 돌 때만 잠깐 나타납니다. 상시 파드 메모리는 합쳐서 약 1.8GiB였습니다. 파드 IP는 가렸습니다.
설치 1: 비밀값은 모두 Sealed Secret으로
차트는 암호화 키(fernet), API 키, JWT 키를 값을 주지 않으면 스스로 만들어 냅니다. 하지만 Argo CD는 차트를 렌더링할 때마다 새 값을 만들어 클러스터와 계속 다투게 됩니다. 그래서 값을 미리 무작위로 만들어 9편의 Sealed Secret으로 Git에 넣었습니다. 평문은 화면이나 파일에 남기지 않고 파이프로만 넘겼습니다.
# WSL에서: 무작위 값 → Secret YAML(--dry-run) → kubeseal로 암호화한 것만 파일로DBPW=$(openssl rand -hex 24)DB=airflow-db-rw.airflow.svc:5432 # CloudNativePG가 만드는 주 서버 Servicekubectl -n airflow create secret generic airflow-metadata \ --from-literal=connection="postgresql://airflow:$DBPW@$DB/airflow" \ --dry-run=client -o yaml | kubeseal --format yaml > platform/airflow/sealed-metadata.yaml# 같은 비밀번호로 DB 계정 Secret(airflow-db-credentials, 키 username·password)을 만들고,# 같은 방식으로 airflow-fernet-key, airflow-api-secret-key, airflow-jwt-secret,# airflow-admin(관리자 비밀번호), airflow-git-ssh(DAG를 받을 SSH 키)겪은 문제: JWT 키 파일만 Git에 안 올라감
push하고 나니 api-server와 scheduler가
CreateContainerConfigError: secret "airflow-jwt-secret" not found로 뜨지 않았습니다. 확인해 보니 이 저장소의.gitignore에 평문 Secret을 실수로 올리지 않으려고 넣어 둔*-secret.yaml규칙이 있었고,sealed-jwt-secret.yaml이라는 이름이 여기에 걸려 커밋에서 조용히 빠져 있었습니다.git status에도 보이지 않습니다. 이름을sealed-jwt.yaml로 바꿔 다시 push하자 1분 안에 정상이 됐습니다. 안전장치로 넣은 규칙이 정상 파일까지 막을 수 있으니, 커밋 뒤git ls-files로 파일이 들어갔는지 확인하는 편이 좋습니다.
DAG를 받아 올 git-sync는 SSH로 GitOps 저장소에 붙습니다. 실습에서는 Argo CD가 쓰는 읽기 전용 배포 키를 같이 썼지만, 운영에서는 용도별로 키를 따로 두는 편이 좋습니다. GitHub 호스트 키는 Argo CD에 등록된 값을 가져와 GitHub가 공개한 지문(ED25519 SHA256:+DiY3wvvV6TuJJhbpZisF/zLDA0zPMSvHdkr4UvCOqU)과 같은지 확인한 뒤 넣었습니다.
설치 2: 메타데이터 DB와 차트 값
DB는 차트에 들어 있는 PostgreSQL 대신 7편에서 쓴 CloudNativePG로 따로 만들었습니다. 주 서버와 복제본을 서로 다른 노드에 두어 장애 전환을 시험할 수 있게 했습니다.
# platform/airflow/airflow-db.yaml (일부)apiVersion: postgresql.cnpg.io/v1kind: Clustermetadata: name: airflow-db namespace: airflowspec: instances: 2 affinity: enablePodAntiAffinity: true podAntiAffinityType: required bootstrap: initdb: database: airflow owner: airflow secret: { name: airflow-db-credentials } # 위에서 만든 Sealed Secret storage: { size: 2Gi }차트 값에서 가장 중요한 것은 공식 문서가 “Argo CD로 설치할 때 반드시 넣으라”고 한 네 값입니다. DB 마이그레이션과 관리자 생성 작업을 Helm 훅 대신 일반 Job으로 돌리게 하는 설정입니다.
# platform/airflow-chart/values.yaml (일부)airflowVersion: "3.2.2"defaultAirflowTag: "3.2.2"executor: KubernetesExecutor
createUserJob:  useHelmHooks: false            # Argo CD로 설치할 때 필수 네 값  applyCustomEnv: false  # 기본값은 values에 비밀번호(admin)를 평문으로 적는 방식이라, 명령을 바꿔 Secret에서 받음  args: [bash, -c, 'exec airflow users create -r Admin -u admin -e <관리자 이메일> -f lab -l admin -p "$ADMIN_PASSWORD"']  env:    - name: ADMIN_PASSWORD      valueFrom: { secretKeyRef: { name: airflow-admin, key: password } }migrateDatabaseJob:  useHelmHooks: false  applyCustomEnv: false  jobAnnotations:    argocd.argoproj.io/hook: Sync    # 동기화할 때마다 DB 마이그레이션 실행
postgresql: { enabled: false }       # 차트 내장 DB 대신 CloudNativePGdata:  metadataSecretName: airflow-metadatafernetKeySecretName: airflow-fernet-keyapiSecretKeySecretName: airflow-api-secret-keyjwtSecretName: airflow-jwt-secret
dags:  gitSync:    enabled: true    repo: <GitOps 저장소 SSH 주소>     # GitHub의 SSH 클론 주소    branch: main    subPath: airflow-dags            # 이 폴더의 파이썬 파일이 DAG    period: 30s    sshKeySecret: airflow-git-ssh
logs:  persistence: { enabled: false }    # 로그 저장소 없이(뒤에서 설명)workers:  resources:    requests: { cpu: 50m, memory: 256Mi }    limits: { memory: 768Mi }
push부터 DB 생성, 이미지 받기, 마이그레이션까지 약 4분 걸렸고, JWT 문제를 고친 뒤 Synced Healthy가 됐습니다. 화면은 6편의 사설 인증서를 쓰는 https://airflow.localhost:8443으로 열었습니다.
첫 DAG: 추출 → 집계 → 리포트
Airflow 3에서는 airflow.sdk의 @dag, @task로 DAG를 씁니다. 함수의 반환값이 다음 태스크의 입력이 되고, 그 연결이 곧 실행 순서가 됩니다.
# airflow-dags/lab_pipeline.py (일부)@dag(    dag_id="lab_pipeline",    schedule="*/10 * * * *",          # 10분마다    start_date=datetime(2026, 11, 15),    catchup=False,    default_args={"retries": 2, "retry_delay": timedelta(seconds=30)},)def lab_pipeline():    @task    def extract() -> list[int]:        orders = [random.randint(1000, 50000) for _ in range(20)]        print(f"주문 {len(orders)}건 읽음")        return orders
    @task    def transform(orders: list[int]) -> dict:        time.sleep(5)        return {"count": len(orders), "total": sum(orders), "max": max(orders)}
    @task    def report(summary: dict) -> None:        print(f"리포트: 주문 {summary['count']}건, 합계 {summary['total']}원")
    report(transform(extract()))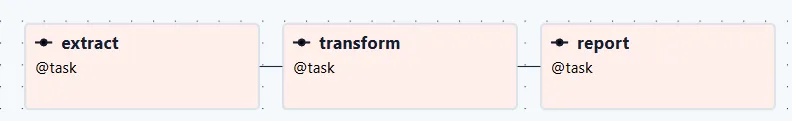
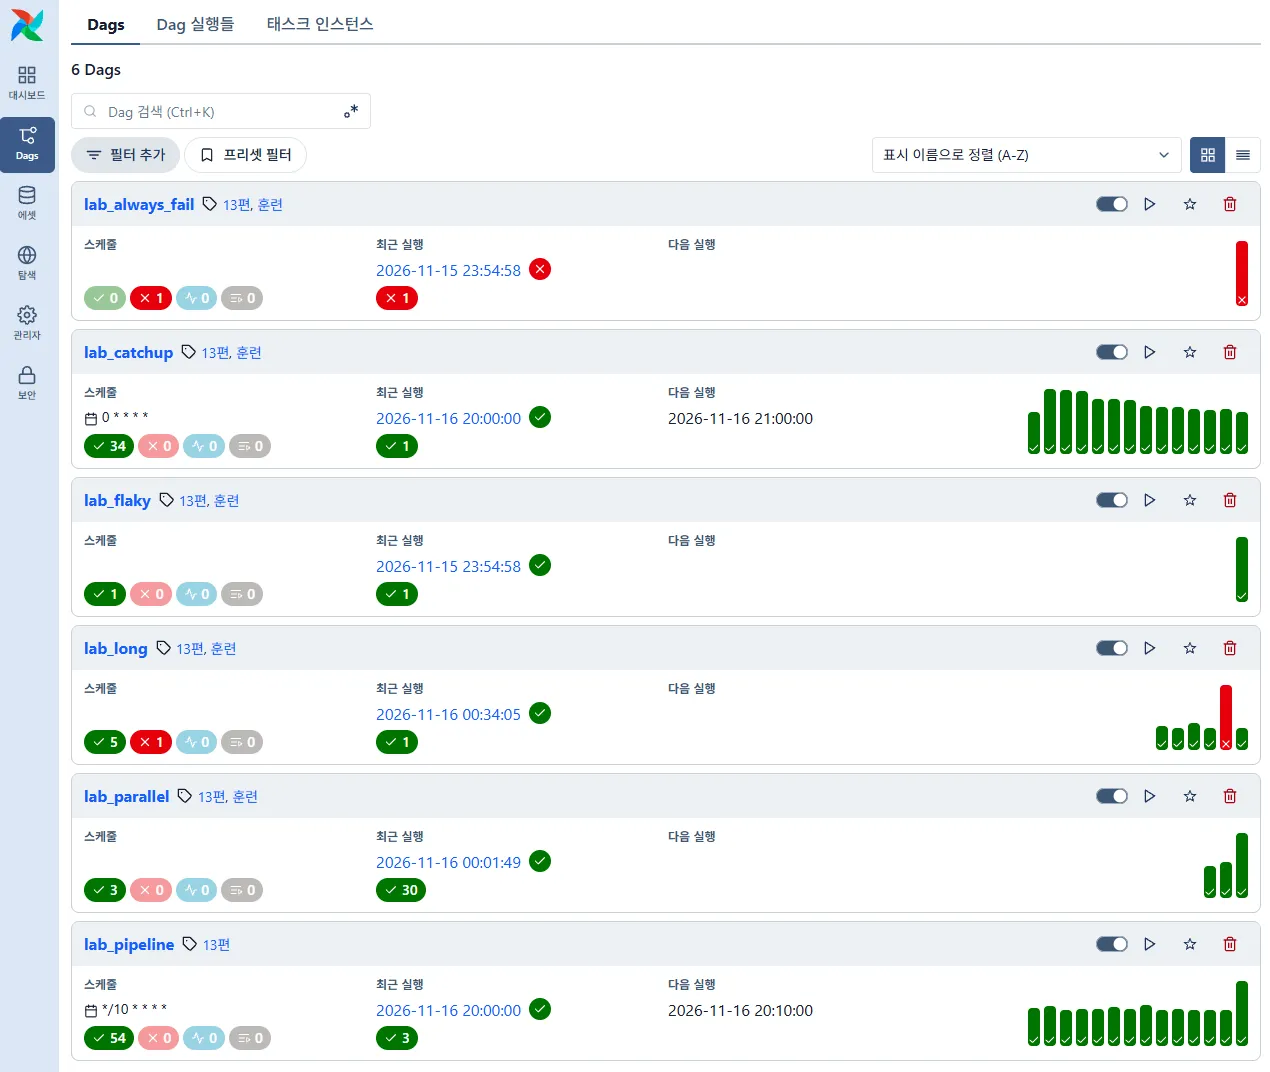
새 DAG는 기본으로 일시 정지 상태로 등록됩니다(dags_are_paused_at_creation). 정지를 풀면서 수동 실행도 눌렀더니, 정지를 푸는 순간 예약 실행도 하나 생겨 두 실행이 동시에 돌았습니다. 정지를 풀기만 해도 예약 실행이 시작된다는 점을 기억해 두면 좋습니다.
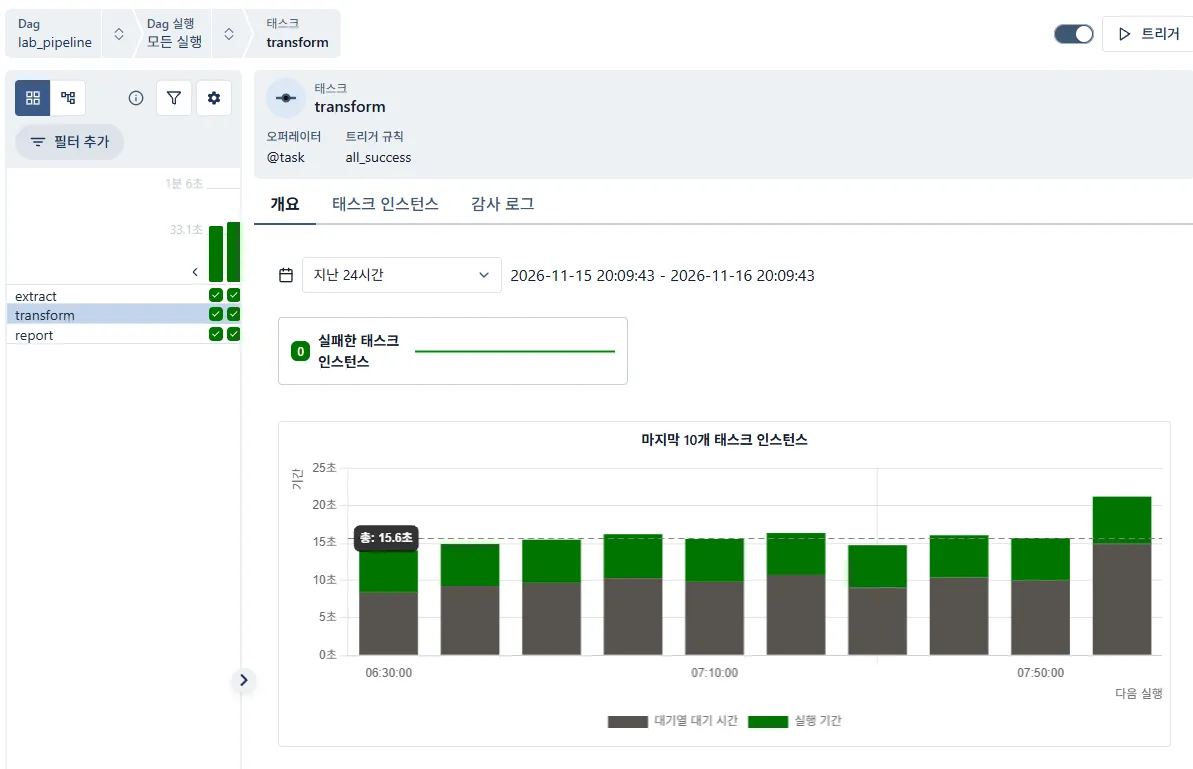
transform 태스크의 기록입니다. 회색이 대기열에서 기다린 시간, 초록이 실제 실행 시간입니다. 함수는 5초 남짓인데, 매번 10초 안팎을 기다립니다. KubernetesExecutor는 태스크마다 파드를 새로 띄우고 DAG 파일도 새로 받아 오기 때문입니다. 실행 한 번(태스크 3개)이 50~70초 걸렸습니다. 짧은 작업이 아주 많다면 이 시작 비용이 부담이 될 수 있습니다.
로그: 가장 단순한 방법과 그 대가
KubernetesExecutor에서는 태스크가 끝나면 파드가 지워집니다. 차트 문서에 따르면 로그를 남기려면 모든 구성 요소가 함께 쓰는 ReadWriteMany 볼륨이나 Elasticsearch 같은 원격 저장소가 필요합니다. kind의 기본 저장소는 ReadWriteOnce라 공유 볼륨을 쓸 수 없어서, 이번에는 아무것도 붙이지 않고 표준 출력을 5편의 Fluent Bit·Loki가 모으게 했습니다.
겪은 문제: 짧은 작업 파드의 로그가 Loki에서 빠짐
첫 실행 뒤 Loki를 보니 작업 파드 6개 중 extract 2개의 로그만 있었습니다. Fluent Bit의 tail 입력은 새 로그 파일을 찾는 주기(
Refresh_Interval)가 기본 60초인데, 작업 파드는 20~30초 만에 끝나 지워지니 목록을 갱신하기도 전에 파일이 사라진 것입니다. 5편 Fluent Bit 설정에Refresh_Interval 5를 넣자 extract, transform, report 세 개 모두 들어왔습니다.
# platform/fluent-bit/values.yaml (일부)[INPUT] Name tail Path /var/log/containers/*.log multiline.parser docker, cri Tag kube.* Refresh_Interval 5 # 기본 60초 → 짧게 끝나는 파드도 놓치지 않게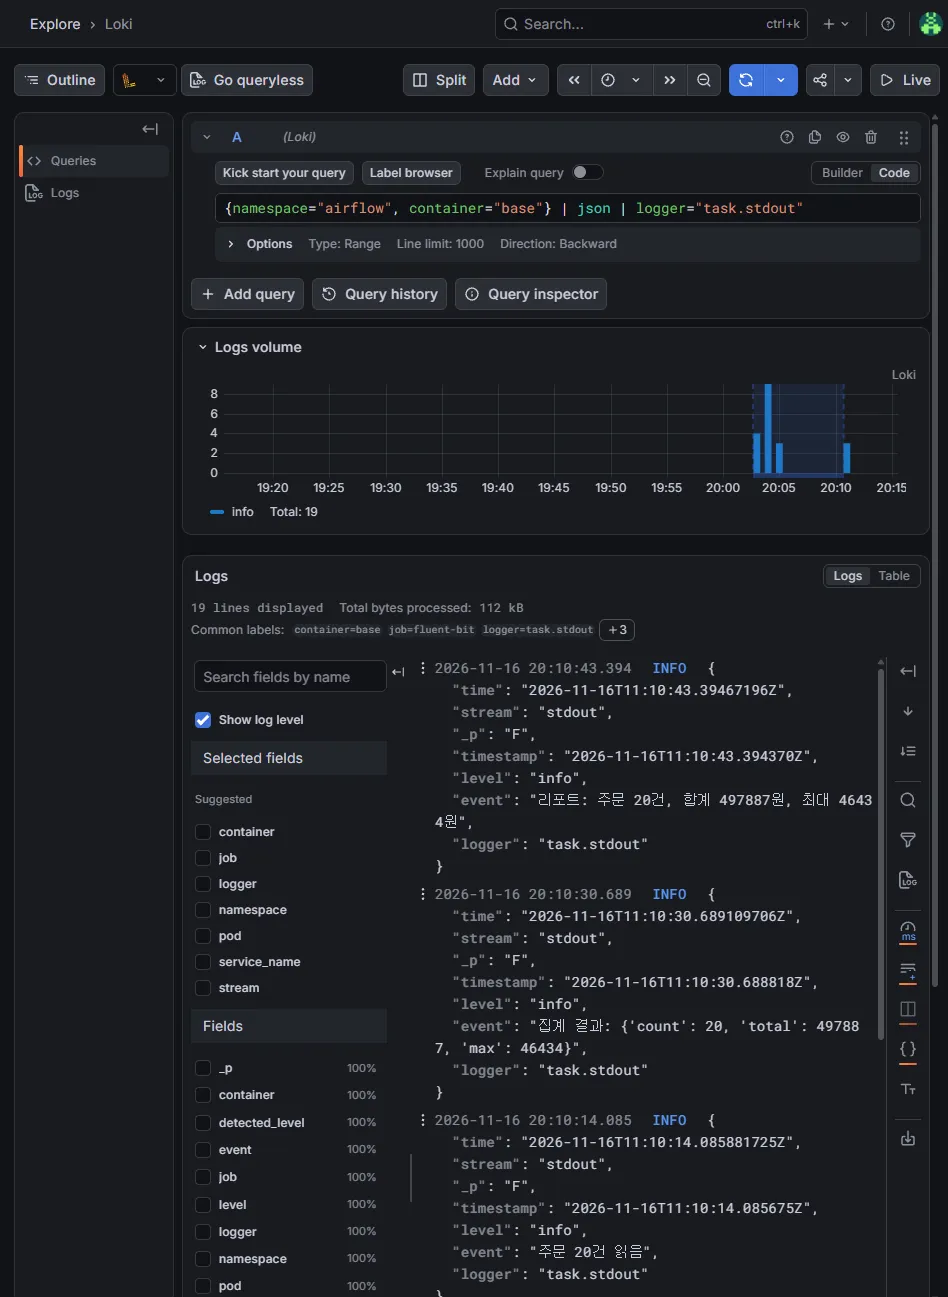
Grafana에서 Loki로 본 작업 출력입니다. Airflow 3의 작업 로그는 JSON 한 줄씩 나오고, print()로 찍은 내용은 logger가 task.stdout인 줄로 남습니다. {namespace="airflow", container="base"} | json | logger="task.stdout"로 걸러 보면 됩니다. 한글은 JSON 안에서 \uXXXX로 바뀌어 저장되므로, |= "리포트"처럼 한글 문자열로 바로 검색하면 걸리지 않았습니다. | json으로 푼 뒤 필드로 거르는 편이 낫습니다.
지표와 경보
차트에 들어 있는 StatsD Exporter를 ServiceMonitor로 4편 Prometheus에 연결했습니다. 지표는 102종이 들어왔고, 그중 구성 요소의 heartbeat와 DAG 읽기 오류, 작업 실패로 경보 4개를 만들었습니다.
# platform/airflow/monitoring.yaml (일부)- alert: AirflowSchedulerDown # heartbeat는 계속 늘어나는 카운터라, 증가가 멈추면 멈춘 것 expr: sum(rate(airflow_scheduler_heartbeat[2m])) == 0 or absent(airflow_scheduler_heartbeat) for: 1m- alert: AirflowDagProcessorDown expr: sum(rate(airflow_dag_processor_heartbeat[2m])) == 0 or absent(airflow_dag_processor_heartbeat) for: 1m- alert: AirflowDagImportErrors # DAG 파일을 읽지 못함(문법 오류 등) expr: max(airflow_dag_processing_import_errors) > 0 for: 1m- alert: AirflowTaskFailed # 재시도까지 모두 실패한 작업 expr: sum(increase(airflow_ti_failures[10m])) > 0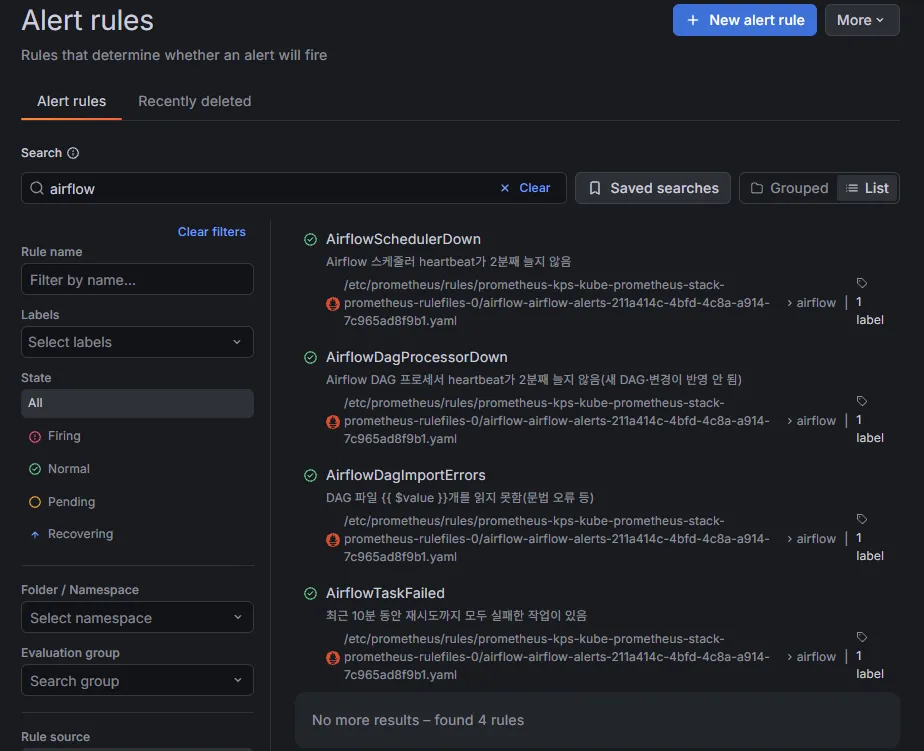
Grafana 경보 규칙 화면입니다. 이 넷 중 셋이 아래 훈련에서 실제로 울렸습니다.
훈련 1: DAG를 push하면 언제 보이나, 문법 오류를 넣으면
훈련용 DAG 파일 4개를 한꺼번에 push했습니다. git-sync는 15초 만에 새 커밋을 받았는데, 화면에 DAG가 나타나기까지는 227초가 걸렸습니다.
원인은 dag-processor 설정이었습니다. 새 파일을 찾으려고 폴더를 다시 훑는 주기([dag_processor] refresh_interval)가 기본 300초이고, 이미 있는 파일의 변경은 30초(min_file_process_interval)마다 다시 읽습니다. 새 DAG를 자주 추가한다면 이 값을 줄이는 것을 검토할 만합니다.
이어서 이미 있는 파일 drill_long.py에 일부러 문법 오류를 넣어 push했습니다.
23:48:37 push(drill_long.py 문법 오류)+21초 lab_long이 DAG 목록에서 사라짐+27초 import 오류: drill_long.py | SyntaxError: invalid syntax+105초 AirflowDagImportErrors pending+167초 AirflowDagImportErrors firing(그동안 lab_pipeline 10분 예약 실행은 정상)23:52:12 되돌림 push → +8초 lab_long 복구 → +103초 경보 해제파일 하나가 깨져도 다른 DAG는 영향을 받지 않았습니다. 다만 깨진 DAG는 목록에서 사라질 뿐 실행이 실패로 남지 않으므로, 읽기 오류 경보가 없으면 “오늘 그 작업이 왜 안 돌았지”를 나중에야 알게 됩니다.
훈련 2: 실패하면 다시 시도한다
외부 API가 처음 두 번은 응답하지 않는 상황을 흉내 낸 DAG(lab_flaky)와, 끝까지 실패하는 DAG(lab_always_fail)를 동시에 돌렸습니다.
@task(retries=3, retry_delay=timedelta(seconds=20))def call_api(): n = get_current_context()["ti"].try_number if n < 3: raise RuntimeError(f"외부 API 응답 없음(시도 {n})") print("성공")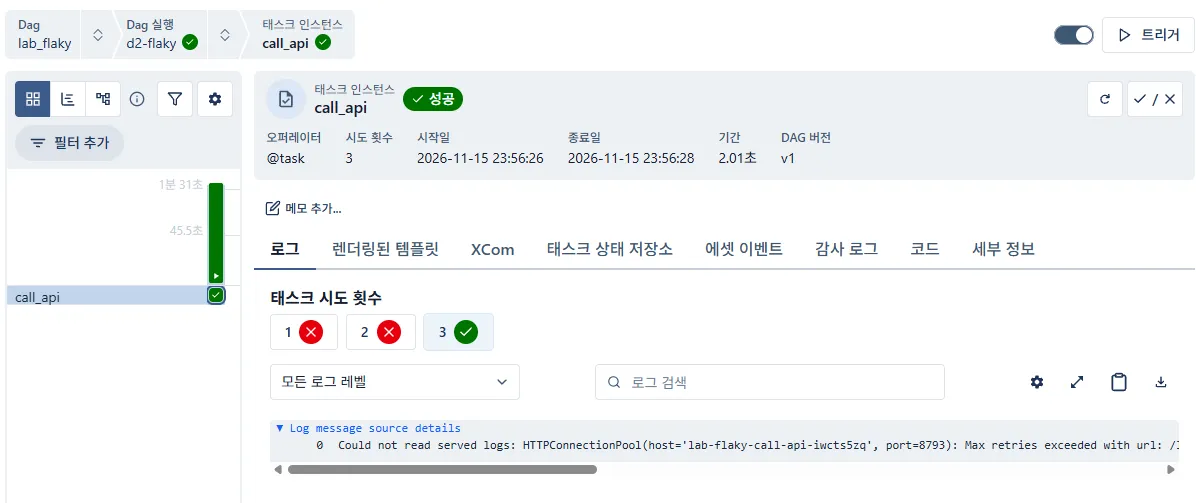
시도 1·2가 실패하고 3번째에 성공했습니다. 시도마다 새 파드가 떴고, 실행 시작부터 성공까지 96초였습니다. 끝까지 실패한 lab_always_fail은 47초 만에 failed가 됐고, AirflowTaskFailed 경보가 실행 시작 118초 뒤 울렸습니다.
아래쪽 로그 칸에 Could not read served logs가 보이는 것은 시도마다 작업 파드가 이미 지워졌기 때문입니다. 실패한 시도의 파드도 남지 않았습니다. Airflow 3의 작업 파드는 태스크가 실패해도 실패를 보고한 뒤 정상 종료(Completed)되어서, “실패하면 파드를 남긴다”는 설정(delete_worker_pods_on_failure)과 상관없이 지워졌습니다. 실패 원인은 Loki에서 확인해야 했습니다.
훈련 3: 한꺼번에 30개를 돌리면
20초짜리 작업 30개를 동적 매핑(work.expand(n=range(30)))으로 한꺼번에 띄웠습니다. 풀은 64자리로 넉넉하게 줬습니다.
풀 64자리: queued 16 + scheduled 14 → Running 파드 최대 16개 → 116초풀 5자리: queued 5 + scheduled 25 → 5개씩 → 229초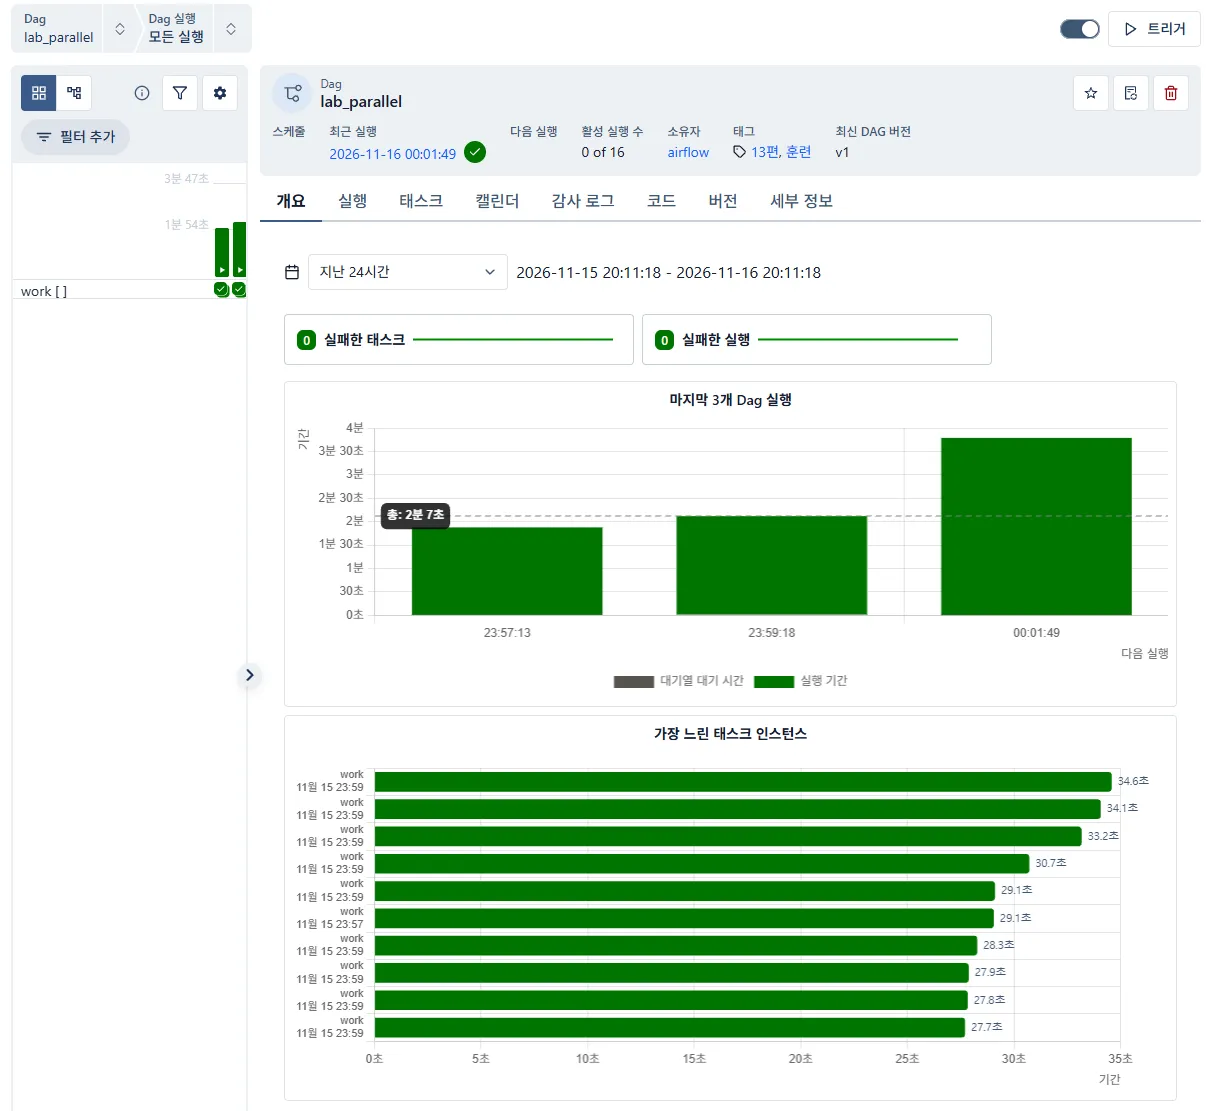
풀이 넉넉한데도 16개를 넘지 않은 것은 DAG 하나가 동시에 돌릴 수 있는 태스크 수(max_active_tasks_per_dag)가 기본 16이기 때문입니다. 클러스터 전체 한도(parallelism)는 기본 32입니다. 화면의 세 막대는 풀 64(약 2분), 풀 PATCH 요청이 잘못돼 다시 64로 돈 실행(약 2분), 풀 5(약 3분 50초)입니다. 처음 풀을 바꿀 때 API가 422를 돌려줘서 값이 바뀌지 않았는데, Airflow 3 REST API는 ?update_mask=slots를 붙여야 했습니다.
어떤 작업이 외부 시스템(DB, API)을 두드린다면 풀 자리 수로 동시에 몇 개까지 보낼지 정해 두는 것이 좋습니다. 파드가 많이 떠도 상대 시스템이 버티지 못하면 의미가 없기 때문입니다.
훈련 4: 밀린 실행 채우기(catchup)
매시간 도는 DAG의 start_date를 12시간 전으로 두고 catchup=True, max_active_runs=3으로 켰습니다.
00:05:48 일시 정지 해제+6초 실행 3개 동시 시작+137초 밀린 14개(02:00 ~ 15:00 UTC 정시) 모두 성공, 동시 실행 최대 3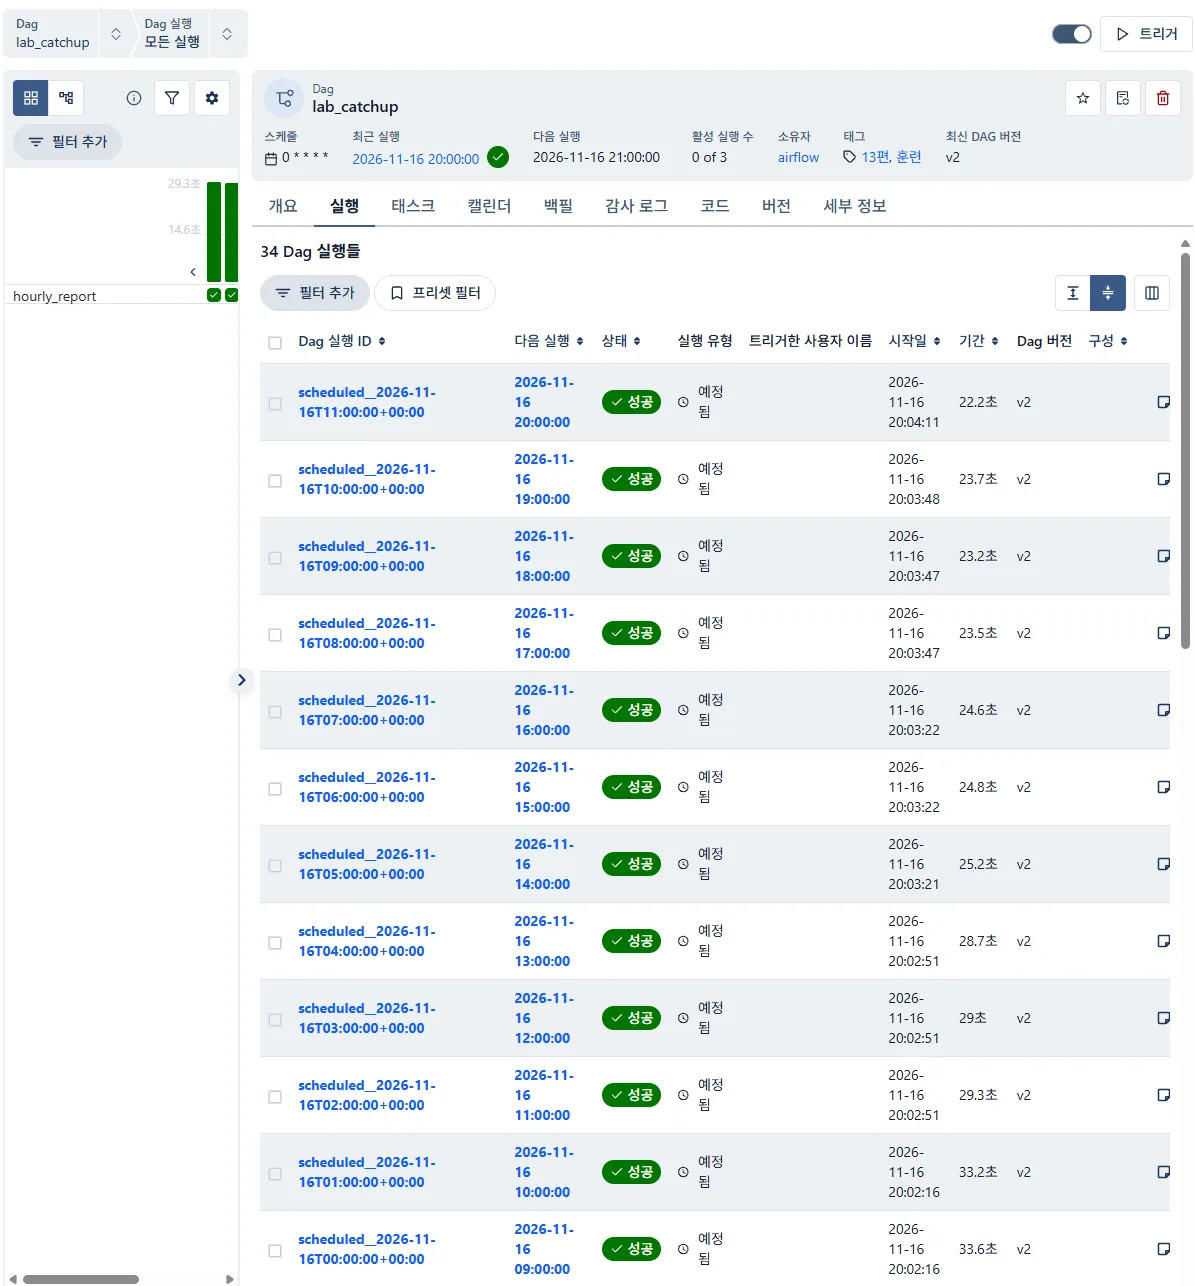
실행 목록입니다. 다음 날 WSL을 다시 켰을 때도 이 DAG는 꺼져 있던 동안의 정시 실행을 3개씩 따라잡아, 화면에는 실행이 34개로 늘어 있었습니다. 빠진 날 없이 처리해야 하는 집계에는 좋은 기능이지만, 정지를 풀거나 클러스터를 다시 켜는 순간 실행이 몰린다는 점도 함께 생각해야 합니다. max_active_runs로 한 번에 도는 수를 꼭 제한해 두는 편이 안전합니다.
Airflow 3에서는 cron 일정이 기본으로 “정시에 실행하고 그 정시를 실행 이름으로 쓰는” 방식이라, 15:00 실행이 15:00에 바로 생겼습니다. Airflow 2의 “구간이 끝난 뒤 실행”과 달라서, 2에서 넘어온 DAG라면 날짜 계산을 한 번 확인해야 합니다.
훈련 5: 작업이 끝나면 로그는 어디에
150초 동안 10초마다 진행을 찍는 작업을 돌리며 로그를 확인했습니다.
로그를 볼 수 있는 곳
| 시점 | Airflow 화면 | Loki |
|---|---|---|
| 작업이 도는 중 | 보임(“진행 10초…”) | 보임 |
| 작업이 끝나 파드가 지워진 뒤 | 안 보임: Could not read served logs … Failed to resolve | 16줄 모두 보임 |
별도 저장소 없이 가는 방법의 대가가 이것입니다. 운영 화면에서 끝난 작업의 로그를 바로 보고 싶다면 S3 같은 원격 로그 저장소나 Elasticsearch를 붙여야 합니다. 이번 실습처럼 Loki로 모으는 것만으로도 기록은 남지만, 담당자가 Airflow 화면과 Grafana를 오가야 합니다.
훈련 6: 작업 중에 스케줄러를 죽이면
150초짜리 작업이 돌기 시작하고 45초 뒤 스케줄러 파드를 강제로 지웠습니다.
+45초 scheduler 파드 강제 삭제 → 작업 파드는 그대로 실행 중+64초 새 scheduler Running → adopt_or_reset_orphaned_tasks 에서 DetachedInstanceError로 종료, 재시작 2번작업이 끝난 뒤(+167초) 세 번째 시작에서 "Attempting to adopt pod" 정상작업 결과: success작업 자체는 끝까지 돌아 성공했습니다. 작업 파드는 스케줄러가 아니라 api-server에 결과를 보고하기 때문입니다. 문제는 새 스케줄러였습니다. 남겨진 작업을 넘겨받는(adopt) 과정에서 다음 오류로 두 번 죽었습니다.
sqlalchemy.orm.exc.DetachedInstanceError: Parent instance <TaskInstance at 0x…> is not bound to a Session;deferred load operation of attribute 'state' cannot proceed찾아보니 이미 보고된 버그였습니다(apache/airflow#67813, apache/airflow#67891). 이슈 댓글에 따르면 KubernetesExecutor가 들어 있는 cncf-kubernetes 제공자 10.18.0에서 고쳐졌는데, apache/airflow:3.2.2 이미지에는 10.17.1이 들어 있었고 우리 이미지도 10.17.1이었습니다. 스케줄러가 두 번 죽는 동안에도 재시작 사이사이 heartbeat가 들어와서 AirflowSchedulerDown 경보는 울리지 않았습니다.
훈련 7: 작업 중에 DB 주 서버를 죽이면
같은 작업을 돌리며 이번에는 DB 주 서버(airflow-db-1)를 강제로 지웠습니다.
00:17:27 airflow-db-1(주) 강제 삭제00:17:47 CloudNativePG가 airflow-db-2를 주 서버로(약 20초), db-1은 복제본으로 돌아옴 scheduler: DB 연결이 끊겨 종료 → 다시 뜰 때 훈련 6의 버그로 또 종료 → CrashLoopBackOff+148초 AirflowSchedulerDown pending → +209초 firing → +240초 해제 api-server: DB 오류 로그만 남기고 재시작 없음작업 결과: successDB 전환은 7편 Keycloak 때처럼 20초 안에 끝났고, 작업도 성공했습니다. 그런데 스케줄러는 DB가 잠깐 끊긴 것을 계기로 재시작했다가, 아직 도는 작업이 있으니 다시 같은 버그에 걸렸습니다. 이번에는 CrashLoopBackOff까지 가서 스케줄러 멈춤 경보가 실제로 울렸습니다. 장애 하나가 다른 버그를 불러온 셈입니다.
훈련 8: 3.2.2 → 3.4.0 업그레이드
3.4.0의 release notes에서 배포에 영향이 있는 것만 먼저 확인했습니다. Python 3.11 이상이 필요하고, PostgreSQL 기본 드라이버가 psycopg3로 바뀌어 postgresql:// 주소를 자동으로 postgresql+psycopg://로 바꿔 쓰며, 마이그레이션이 xcom_v2 테이블을 추가해 이전 버전으로 내리기가 느릴 수 있다고 합니다. 차트 1.22.0과 3.4.0의 호환에 대한 언급은 없었습니다. 그래서 먼저 DB를 백업했습니다.
# 주 서버에서 DB 덤프(업그레이드 전)PRI=$(kubectl -n airflow get cluster airflow-db -o jsonpath='{.status.currentPrimary}')kubectl -n airflow exec $PRI -c postgres -- pg_dump -Fc -d airflow > airflow-db-3.2.2.dump업그레이드 직전에 150초짜리 작업을 하나 시작해 두고, values의 버전 두 줄만 3.4.0으로 바꿔 push했습니다.
00:25:28 push(airflowVersion·defaultAirflowTag 3.4.0)+44초 새 파드 생성 시작(이미지 받기)15:27:45Z DB 마이그레이션 완료15:27:50Z 실행 중이던 작업: "완료" 출력 → 결과 보고 실패(500)+171초 api-server 3.4.0 응답+220초 Argo CD Synced Healthy, 이후 예약 실행 정상15:33:01Z 그 작업: heartbeat 없음 → FAILED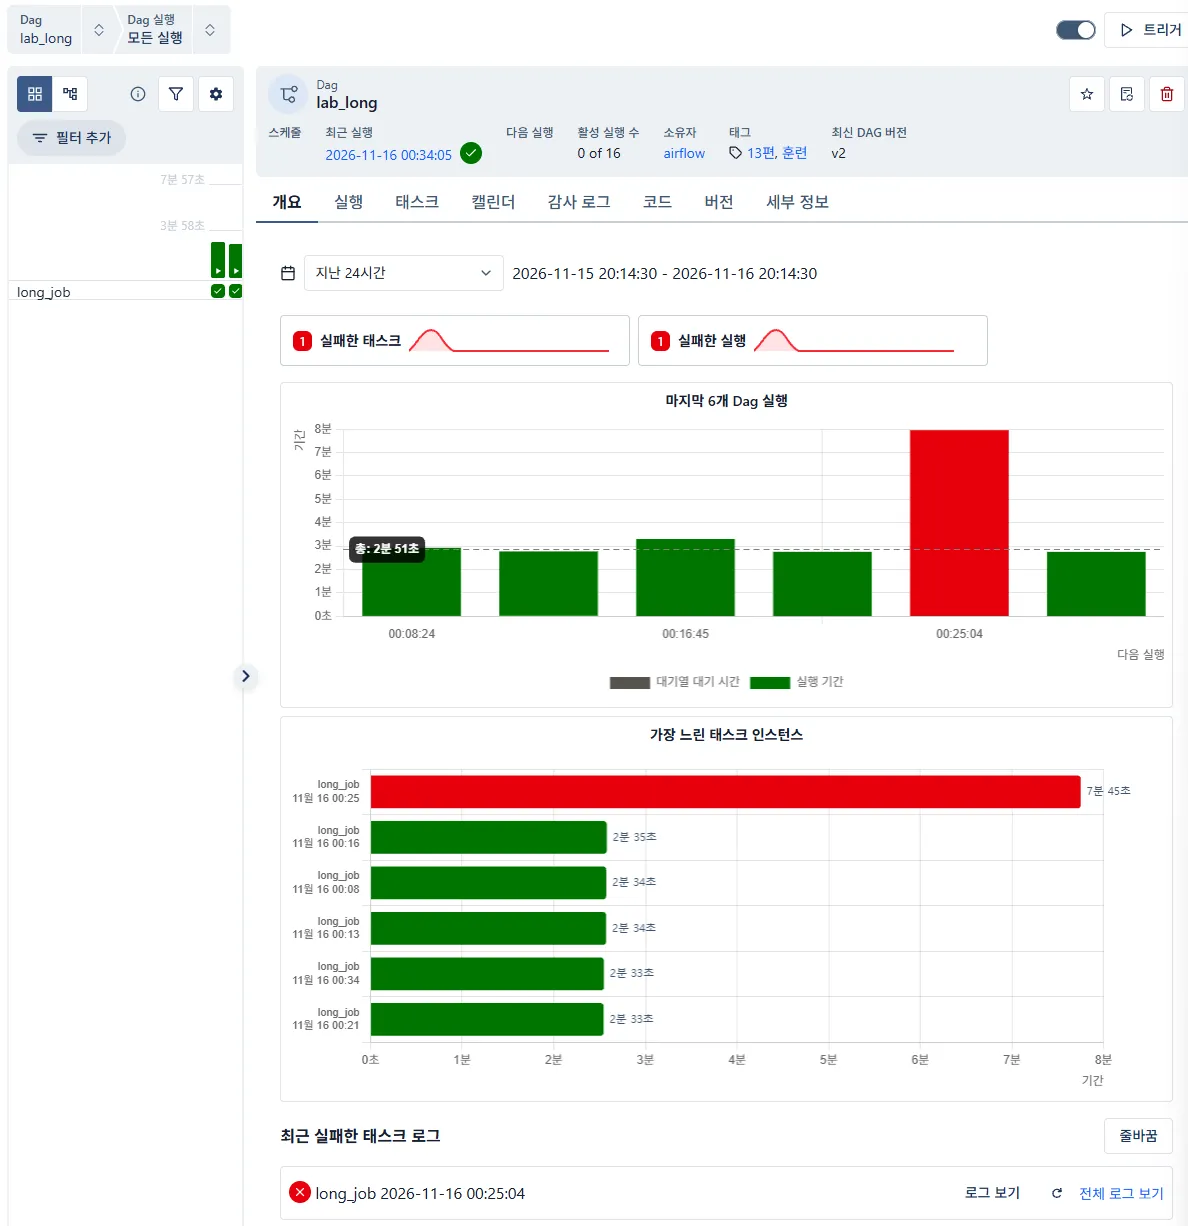
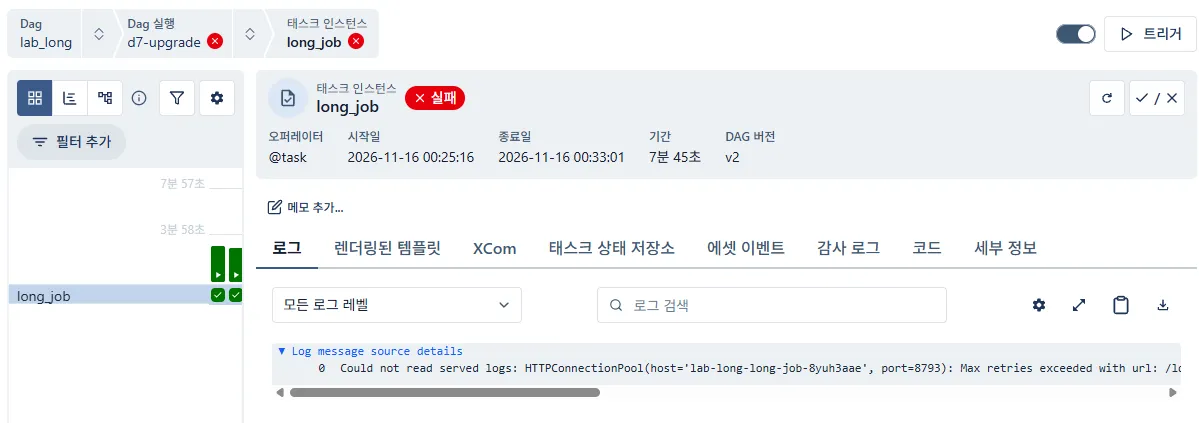
업그레이드는 4분 안에 끝났지만, 업그레이드 중에 일을 다 마친 작업이 실패로 기록됐습니다. Loki에 남은 작업 로그와 옛 api-server 로그를 맞춰 보니 순서는 이랬습니다.
- 마이그레이션 Job이 DB 구조를 3.4.0에 맞게 바꿨습니다.
- 새 api-server가 준비될 때까지 약 34초 동안 옛 3.2.2 api-server가 계속 요청을 받았고, 바뀐 구조를 몰라
column dag_run.span_status does not exist같은 오류로 500을 돌려줬습니다. - 마침 그 사이에 끝난 작업이 결과를 보고하지 못했습니다(
Failed to report terminal task state). - 작업은 running으로 남다가, 5분 뒤 heartbeat가 없다는 이유로 FAILED가 됐습니다. 재시도를 0으로 둔 작업이라 다시 돌지도 않았습니다.
대책은 단순합니다. 업그레이드 전에 DAG를 일시 정지하고 도는 작업이 끝나기를 기다리거나, 중요한 작업에는 재시도를 넣어 두는 것입니다.
업그레이드 뒤 훈련 6(스케줄러 강제 종료)을 같은 조건으로 다시 해 봤습니다. 3.4.0 이미지에는 cncf-kubernetes 10.25.0이 들어 있었고, 새 스케줄러는 재시작 없이 52초 만에 준비됐고 작업도 성공했습니다. 3.2.2에서 만난 버그가 고쳐진 것입니다.
정리: 이번에 만난 함정
훈련별 결과
| 훈련 | 결과 | 핵심 |
|---|---|---|
| 1. DAG 배포 | 새 DAG 등록 227초, 문법 오류 표시 27초, 경보 167초 | 새 파일은 refresh_interval(300초)마다 발견 |
| 2. 재시도 | 3번째 시도 성공, 끝까지 실패하면 경보 | 실패한 시도의 파드도 지워짐 |
| 3. 동시 실행 | 16개씩 116초, 풀 5면 229초 | max_active_tasks_per_dag 기본 16 |
| 4. catchup | 14개를 3개씩 137초 | 켜는 순간 몰리니 max_active_runs 필수 |
| 5. 로그 | 끝난 작업은 화면에서 안 보임, Loki에는 남음 | Fluent Bit 주기 60초 → 5초 |
| 6. 스케줄러 종료 | 작업 성공, 새 스케줄러 2번 재시작 | 3.2.2 버그(제공자 10.17.1) |
| 7. DB 장애 | 20초 전환, 스케줄러 CrashLoopBackOff, 경보 | DB 끊김이 버그를 다시 부름 |
| 8. 업그레이드 | 4분 안에 3.4.0, 진행 중 작업 1건 실패 기록 | 옛 api-server가 새 DB 구조를 모름 |
운영 체크리스트
- Argo CD로 설치할 때는 createUserJob·migrateDatabaseJob의
useHelmHooks: false,applyCustomEnv: false를 넣는다. - fernet·API·JWT 키와 관리자 비밀번호는 미리 만들어 Secret으로 준다. 차트가 만들게 두면 Argo CD와 다툰다.
- Sealed Secret 파일 이름이
.gitignore규칙에 걸리지 않는지, 커밋 뒤git ls-files로 확인한다. - KubernetesExecutor는 작업마다 파드 시작 비용(이번에 10초 안팎)이 있다. 짧은 작업이 많으면 묶거나 다른 executor를 검토한다.
- 로그 저장소가 없으면 끝난 작업 로그는 Airflow 화면에서 사라진다. Loki로 모은다면 Fluent Bit의 Refresh_Interval을 짧게 둔다.
- 새 DAG 파일은 refresh_interval(기본 300초) 뒤에야 보인다. DAG 읽기 오류 경보를 꼭 건다.
- 동시 실행은 parallelism(32), max_active_tasks_per_dag(16), pool 세 겹으로 막힌다. 외부 시스템을 두드리는 작업은 pool로 제한한다.
- catchup을 켠 DAG는 max_active_runs를 두고, 정지 해제·클러스터 재시작 때 실행이 몰리는 것을 감안한다.
- 업그레이드 전에 DB를 백업하고, DAG를 일시 정지해 도는 작업이 없을 때 올린다. 중요한 작업에는 재시도를 둔다.
- Airflow 이미지에 들어 있는 제공자(cncf-kubernetes 등) 버전도 확인한다. 이번 스케줄러 버그는 Airflow 본체가 아니라 제공자에 있었다.
자주 묻는 질문
Airflow와 Argo Workflows는 무엇이 다른가요?
둘 다 순서가 있는 작업을 쿠버네티스에서 돌릴 수 있습니다. Airflow는 파이썬으로 DAG를 쓰고 일정, 재시도, catchup, 실행 이력 같은 데이터 작업 운영 기능이 풍부합니다. Argo Workflows는 YAML로 쓰고 쿠버네티스 리소스로 움직여서 CI나 머신러닝 파이프라인처럼 컨테이너 단계를 잇는 데 더 가깝습니다.
KubernetesExecutor와 CeleryExecutor 중 무엇을 써야 하나요?
KubernetesExecutor는 상시 워커와 Redis가 없어 단순하고, 작업마다 자원과 이미지를 따로 줄 수 있습니다. 대신 작업마다 파드를 띄우는 시간이 듭니다. 짧은 작업이 아주 많다면 상시 워커가 바로 받아 처리하는 CeleryExecutor가 빠를 수 있고, Airflow 차트는 Celery 워커 수를 KEDA로 늘리고 줄이는 설정도 제공합니다.
작업 로그를 Airflow 화면에서 계속 보려면 어떻게 하나요?
작업 파드가 사라져도 남는 곳에 로그를 써야 합니다. 공유 볼륨(ReadWriteMany)을 붙이거나, S3·GCS 같은 원격 로그 저장소나 Elasticsearch·OpenSearch를 설정하면 화면에서 끝난 작업의 로그도 다시 읽어 옵니다.
업그레이드 중 작업이 실패로 기록되는 것을 어떻게 막나요?
이번에는 DB 마이그레이션이 끝난 뒤에도 옛 api-server가 잠시 요청을 받은 것이 원인이었습니다. 업그레이드 전에 DAG를 일시 정지하고 실행 중인 작업이 끝나기를 기다리면 이 틈에 걸리는 작업이 없습니다. 중요한 작업에는 재시도를 넣어, 실패로 기록되더라도 다시 돌게 해 두는 것이 좋습니다.
작성 방식과 다음 편
이 글에 나온 명령, 오류 메시지, 측정값은 모두 1편의 실습 PC에서 직접 실행한 결과이고, 설정은 Airflow와 Airflow Helm 차트 공식 문서, release notes, 관련 GitHub 이슈를 기준으로 했습니다. 화면에 보이던 저장소 주소와 IP는 가렸고, 실행 기록을 정리하고 글을 쓰는 데 AI 도구를 함께 썼습니다. 다음 편에서는 12편의 Kafka와 이번 Airflow를 연결해 볼 예정입니다.