Trivy Operator로 쿠버네티스 취약점 점검하기: 이미지·설정·비밀값 스캔, Grafana 경보, Argo CD로 고치기까지 kind 실습
배포 전에는 CLI로, 배포 뒤에는 Operator로 취약점과 위험한 설정을 찾고, Grafana 경보와 Git 커밋으로 고쳐 가는 과정을 걸린 시간과 함께 기록했습니다
로컬 쿠버네티스 실습 시리즈 목차 · 글 15개
- 1편Windows에서 무료 쿠버네티스 실습 환경 만들기: WSL2 + Docker Engine + kind
- 2편Headlamp 설치와 사용법: 로컬 쿠버네티스를 화면으로 보고 파드 배포하기
- 3편NGINX Ingress 대신 Gateway API: kind 클러스터 앱을 Windows localhost로 접속하기
- 4편kube-prometheus-stack 설치와 Grafana 접속: kind 클러스터 모니터링과 target down 해결
- 5편Fluent Bit과 Loki로 쿠버네티스 로그 모으기: kind 실습과 Grafana 조회, AWS 확장 예시
- 6편cert-manager로 Gateway API HTTPS 붙이기: 사설 CA, 자동 갱신, 만료 알림까지 kind 실습
- 7편Keycloak 운영 모드로 Grafana SSO 만들기: Keycloak Operator, CloudNativePG, 이중화와 장애·백업 훈련
- 8편OpenTelemetry로 쿠버네티스 트레이스 모으기: Collector, Tempo, 샘플링과 장애 훈련까지 kind 실습
- 9편Argo CD로 쿠버네티스 GitOps 전환하기: Helm 설치 넘겨받기, Sealed Secrets, Keycloak SSO와 장애 훈련까지 kind 실습
- 부록Argo CD로 nginx 파드 하나 배포하기: GitHub에서 파일 두 개 커밋하고 replicas 바꿔 보기
- 10편Trivy Operator로 쿠버네티스 취약점 점검하기: 이미지·설정·비밀값 스캔, Grafana 경보, Argo CD로 고치기까지 kind 실습
- 번외편Trivy로 찾은 컨테이너 이미지 취약점 고치기: nginx apk upgrade, Go 의존성 올리기, Grafana처럼 직접 못 고치는 경우까지
- 11편Istio Ambient 모드로 서비스 메시 붙이기: 사이드카 없이 mTLS, 권한 정책, waypoint 트래픽 분할과 장애 훈련까지 kind 실습
- 12편Strimzi로 쿠버네티스에 Kafka 올리기: KRaft 브로커 3대, SCRAM·ACL, 소비 지연 경보와 장애·업그레이드 훈련까지 kind 실습
- 13편Airflow를 쿠버네티스에 올리기: KubernetesExecutor, git-sync DAG 배포, 재시도·catchup부터 스케줄러 장애와 3.4 업그레이드까지 kind 실습
Trivy는 컨테이너 이미지에 알려진 취약점(CVE)이 있는지, 쿠버네티스 설정이 위험하지 않은지 찾아 주는 오픈소스 도구입니다. 배포하기 전에는 Trivy CLI로 점검하고, 배포한 뒤에는 Trivy Operator가 클러스터 안에서 계속 점검합니다. 이번 편에서는 9편까지 만든 클러스터에 Trivy Operator를 설치하고 Grafana 경보를 붙였습니다. 오래된 nginx 1.19를 배포하니 약 10분 뒤 경보가 왔고, 이미지 태그를 올리는 커밋 하나로 2분 41초 만에 경보가 풀렸습니다. 설치하면서 겪은 문제 두 가지와, 취약점 DB를 받지 못할 때 대시보드가 정상처럼 보이는 함정도 함께 정리했습니다.
1~9편에서 만든 kind 클러스터를 그대로 이어서 씁니다. 버전은 Trivy CLI 0.76.2, Trivy Operator 0.36.1(차트 aqua/trivy-operator 0.38.1)입니다. 내려받은 파일과 컨테이너 이미지는 체크섬과 cosign 서명을 확인한 뒤 버전과 digest로 고정했습니다. Trivy Operator는 결과를 알려 줄 뿐 배포를 막지는 않으며, 배포를 막는 방법(admission 정책)은 이번 편에서 다루지 않습니다.
이번 편에서 만드는 구성
9편까지 만든 클러스터에는 Grafana, Keycloak, PostgreSQL, Envoy, Argo CD 같은 이미지가 30개 넘게 떠 있습니다. 그런데 이 이미지에 알려진 취약점이 있는지, 설정에 위험한 곳은 없는지 지금까지 아무도 살펴보지 않았습니다. 이번 편에서는 이 점검을 배포 전과 배포 후 두 단계로 붙입니다.
10편 구성 요소
| 구성 요소 | 위치 | 역할 |
|---|---|---|
| Trivy CLI 0.76.2 | WSL(실습 PC) | 배포 전 점검: 이미지 취약점, YAML 설정, 저장소 안 비밀값 |
| Trivy Operator 0.36.1 | trivy-system 네임스페이스 | 배포 후 점검: 떠 있는 워크로드를 계속 스캔해 보고서 리소스와 지표로 남김 |
| Trivy 서버(StatefulSet) | trivy-system | 취약점 DB를 한 번만 받아 두고 스캔 잡의 질문에 답함(내장 서버 방식) |
| Grafana 대시보드·경보 | monitoring, trivy-system | 4편 kube-prometheus-stack에 대시보드 1개와 경보 규칙 3개 추가 |
| Application 2개 | argocd | trivy-operator(Helm 차트), trivy-config(대시보드·경보). 9편처럼 Git 커밋으로만 바꿈 |
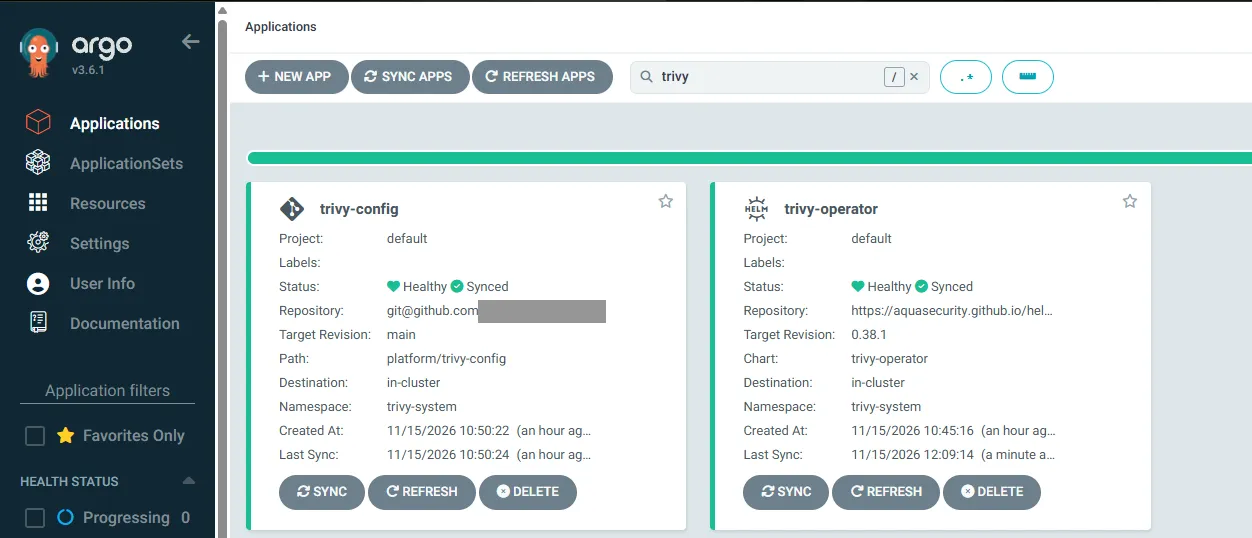
설치를 마친 뒤 Argo CD 화면입니다. 두 Application 모두 Synced, Healthy 상태이고, 클러스터 전체 Application은 9편의 20개에서 22개로 늘었습니다.
Trivy가 점검하는 것과 두 가지 사용 방식
Trivy는 이미지 안에 설치된 패키지 목록을 만든 뒤, 취약점 DB와 맞춰 보며 알려진 CVE를 찾습니다. 같은 도구로 쿠버네티스 YAML에서 root 실행이나 권한 상승 허용 같은 위험한 설정을 찾고, 파일 안에 남은 개인 키나 토큰도 찾습니다. 쓰는 방법은 두 가지입니다.
Trivy CLI와 Trivy Operator 비교
| 구분 | Trivy CLI | Trivy Operator |
|---|---|---|
| 언제 | 배포 전(개발 PC, CI) | 배포 후(클러스터에 떠 있는 동안 계속) |
| 대상 | 지정한 이미지·폴더·YAML | 클러스터의 모든 워크로드, 노드, RBAC |
| 결과 | 화면 표·JSON, 종료 코드 | 쿠버네티스 리소스(보고서 CRD) + Prometheus 지표 |
| 막을 수 있나 | --exit-code 1로 CI 단계를 실패시킬 수 있음 |
보고만 함. 배포를 막지 않음 |
Trivy Operator가 만드는 보고서 리소스는 12종입니다. 이번 실습에서 주로 본 것은 다음 다섯 가지입니다.
Trivy Operator 주요 보고서
| 리소스 | 단위 | 내용 |
|---|---|---|
| VulnerabilityReport | 컨테이너마다 | 이미지의 CVE 목록과 심각도별 개수, 고친 버전 |
| ConfigAuditReport | 워크로드마다 | securityContext, 자원 제한 등 설정 점검 결과(실패 항목만 기록) |
| ExposedSecretReport | 컨테이너마다 | 이미지 안에서 찾은 비밀값(개인 키, 토큰 등) |
| RbacAssessmentReport | Role·ClusterRole마다 | 과도한 권한(Secret 접근, 와일드카드 등) |
| ClusterInfraAssessmentReport | 노드마다 | 노드 파일 권한 등 CIS 기준 점검(node-collector 잡이 수집) |
차트 기본값으로 설치하면 이 스캐너가 모두 켜집니다. 설정 감사는 Operator가 그 자리에서 바로 계산하지만, 취약점과 비밀값 스캔은 이미지마다 스캔 잡(Job)을 따로 띄워 처리합니다. 뒤에서 나오는 속도 차이와 장애가 모두 이 구조에서 생깁니다.
먼저 Trivy 자체를 확인: 2026년 3월 공급망 사고
점검 도구도 공격받을 수 있습니다. 2026년 3월, 공격자가 훔친 자격 증명으로 악성 Trivy v0.69.4 바이너리와 이미지를 배포했습니다. GitHub Actions용 trivy-action과 setup-trivy의 버전 태그도 악성 코드를 가리키도록 바꿔 놓았고, 며칠 뒤에는 Docker Hub에 악성 v0.69.5, v0.69.6 이미지까지 올라왔습니다(CVE-2026-33634). 자세한 경위는 Aqua Security 공지에 있습니다.
그래서 이번 실습에서는 태그 이름만 보고 받지 않기로 했습니다. Trivy는 v0.68.1부터 릴리스 파일마다 sigstore 서명 묶음(.sigstore.json)을 함께 올립니다. 체크섬과 서명을 둘 다 확인한 다음 설치했습니다.
V=0.76.2A=trivy_${V}_Linux-64bit.tar.gzB=https://github.com/aquasecurity/trivy/releases/download/v$Vcurl -sSfLO $B/$Acurl -sSfLO $B/trivy_${V}_checksums.txtcurl -sSfLO $B/$A.sigstore.jsongrep "Linux-64bit.tar.gz$" trivy_${V}_checksums.txt | sha256sum -c -# trivy_0.76.2_Linux-64bit.tar.gz: OKcosign verify-blob $A --bundle $A.sigstore.json \ --certificate-oidc-issuer=https://token.actions.githubusercontent.com \ --certificate-identity "https://github.com/aquasecurity/trivy/.github/workflows/reusable-release.yaml@refs/tags/v$V"# Verified OKcosign(v3.1.4)도 GitHub 릴리스에서 받아 체크섬부터 확인했습니다. 서명 확인 명령은 Trivy 서명 확인 문서를 따랐고, 클러스터에서 쓸 이미지도 같은 방법으로 확인했습니다.
cosign verify docker.io/aquasec/trivy:0.76.2 \ --certificate-identity-regexp 'https://github\.com/aquasecurity/trivy/\.github/workflows/.+' \ --certificate-oidc-issuer https://token.actions.githubusercontent.com# 서명 확인 통과, digest sha256:8f6bb947...cosign verify docker.io/aquasec/trivy-operator:0.36.1 \ --certificate-identity-regexp 'https://github\.com/aquasecurity/trivy-operator/\.github/workflows/.+' \ --certificate-oidc-issuer https://token.actions.githubusercontent.com# 서명 확인 통과, digest sha256:05191a51...차트는 Docker Hub 대신 mirror.gcr.io에서 이미지를 받도록 되어 있습니다. 두 곳의 digest가 같은 것을 확인하고, values에 태그@digest 형식으로 적었습니다. 이렇게 해 두면 누가 같은 태그에 다른 이미지를 올려도 클러스터는 확인한 이미지만 받습니다.
운영 포인트
CI에서 trivy-action 같은 GitHub Action을 쓴다면
@v0.x같은 태그 대신 확인한 커밋 SHA로 고정하세요. 이번 사고에서 바뀐 것이 바로 태그가 가리키는 커밋이었습니다.
CLI로 이미지 점검하기
Trivy를 처음 실행하면 취약점 DB부터 받습니다. 실습 PC에서는 mirror.gcr.io/aquasec/trivy-db 134MiB를 9초 만에 받았고, 풀고 나니 1.7GB였습니다. 그다음 이미지 몇 개를 스캔해 심각도별 개수를 비교했습니다.
trivy image --severity CRITICAL nginx:1.19-alpine# Total: 9 (CRITICAL: 9)# apk-tools CVE-2021-36159 CRITICAL fixed 2.12.5-r0 → 2.12.6-r0# curl CVE-2021-22945 CRITICAL fixed 7.76.1-r0 → 7.79.0-r0# ...이미지별 스캔 결과(Trivy 0.76.2, 2026년 11월 기준 DB)
| 이미지 | Critical | High | Medium | 고친 버전이 있는 항목 |
|---|---|---|---|---|
| nginx:1.19-alpine(alpine 3.13) | 9 | 52 | 29 | 96개 |
| nginx:1.31-alpine | 0 | 3 | 2 | 5개 |
| grafana/grafana:13.3.0-distroless(4편에서 설치) | 0 | 54 | 140 | 222개 |
같은 nginx인데도 오래된 베이스 이미지(alpine 3.13)를 쓰는 1.19에는 Critical이 9개 있고, 1.31에는 하나도 없습니다. “고친 버전” 칸에 값이 있으면 이미지를 새로 빌드하거나 태그만 올려도 해결된다는 뜻입니다. 최신 이미지에도 High 몇 개는 흔히 남습니다. 모두 0으로 만들기보다 Critical과 고칠 수 있는 항목부터 처리하는 기준을 정해 두는 것이 좋습니다.
CLI로 매니페스트 점검하기: push 전 단계
trivy config는 YAML 파일을 읽어 위험한 설정을 찾습니다. 9편의 Argo CD 저장소 전체를 점검해 봤습니다.
cd argocd # 9편의 GitOps 저장소trivy config .# 점검 대상 쿠버네티스 파일 40개, 실패 1개# KSV-01010 (MEDIUM): ConfigMap 'tempo-datasource' stores sensitive contents in key(s) or value(s) '- key'trivy fs --scanners secret .# 비밀값 0건지적은 하나였고, 그것도 오탐이었습니다. Grafana 데이터 소스 설정에 있는 - key: k8s.namespace.name 줄의 “key”를 비밀값으로 잘못 읽은 것입니다. 결과가 이렇게 적은 데는 이유가 있습니다. 이 저장소에는 Argo CD Application과 Helm 값 파일이 대부분이라, 차트가 실제로 만드는 Deployment가 들어 있지 않습니다. 차트까지 점검하려면 helm template으로 먼저 그려야 합니다.
helm template trivy-operator aqua/trivy-operator --version 0.38.1 \ -n trivy-system -f platform/trivy-operator/values.yaml > /tmp/toscan/to.yamltrivy config /tmp/toscan# Failures: 14 (CRITICAL: 1, HIGH: 3, MEDIUM: 6, LOW: 4)# KSV-0041 (CRITICAL): ClusterRole 'trivy-operator' shouldn't have access to manage resource 'secrets'# KSV-0047 (HIGH): Role permits privilege escalation from node proxy# KSV-0118 (HIGH): deployment trivy-operator ... is using the default security context, which allows root privileges재미있게도 Trivy는 자기 Operator 차트에서도 14개를 지적했습니다. 그중 CRITICAL은 “Secret을 관리할 수 있는 권한”인데, Operator가 사설 레지스트리 로그인 정보를 읽으려면 꼭 필요한 권한입니다. 그래서 지적이 나왔다고 모두 고칠 필요는 없습니다. 다만 왜 이 권한이 필요한지는 설명할 수 있어야 합니다.
CI나 push 직전에 막고 싶다면 종료 코드를 쓰면 됩니다. 뒤의 훈련에 쓸 오래된 nginx 매니페스트로 확인했습니다.
trivy config --severity HIGH,CRITICAL --exit-code 1 platform/vuln-demo# Tests: 23 (SUCCESSES: 20, FAILURES: 3) → 종료 코드 1trivy image --severity CRITICAL --exit-code 1 nginx:1.19-alpine# → 종료 코드 1두 명령 모두 종료 코드 1로 끝나므로, CI 파이프라인에 넣으면 여기서 배포가 멈춥니다. 이번 실습에서는 Operator가 배포 뒤에 잡아내는 과정을 보려고 일부러 그대로 push했습니다.
Trivy Operator 설치: Argo CD Application으로
9편부터 이 클러스터는 Git 커밋으로만 바꿉니다. 차트는 https://aquasecurity.github.io/helm-charts/ 저장소에서 받았습니다. OCI 주소(ghcr.io/aquasecurity/helm-charts/trivy-operator)에는 0.32.1까지만 있어서, 최신 0.38.1이 있는 HTTP 저장소를 썼습니다.
# platform/trivy-operator/values.yaml (처음 버전)image: registry: mirror.gcr.io repository: aquasec/trivy-operator tag: "0.36.1@sha256:05191a51..." # 서명 확인한 digesttrivy: image: registry: mirror.gcr.io repository: aquasec/trivy tag: "0.76.2@sha256:8f6bb947..." # 차트 기본 0.76.1 → CLI와 같은 0.76.2operator: scanJobsConcurrentLimit: 3 # 기본 10 → 로컬 PC에 맞게serviceMonitor: enabled: true labels: release: kps # 4편 Prometheus가 이 라벨만 수집Application은 apps/03-trivy-operator.yaml에 두고 sync wave를 -3으로 정했습니다. ServiceMonitor CRD를 만드는 kube-prometheus-stack(wave -4)보다 뒤에 설치되게 하려는 것입니다. CRD가 12종이나 돼서 9편처럼 ServerSideApply=true도 붙였습니다.
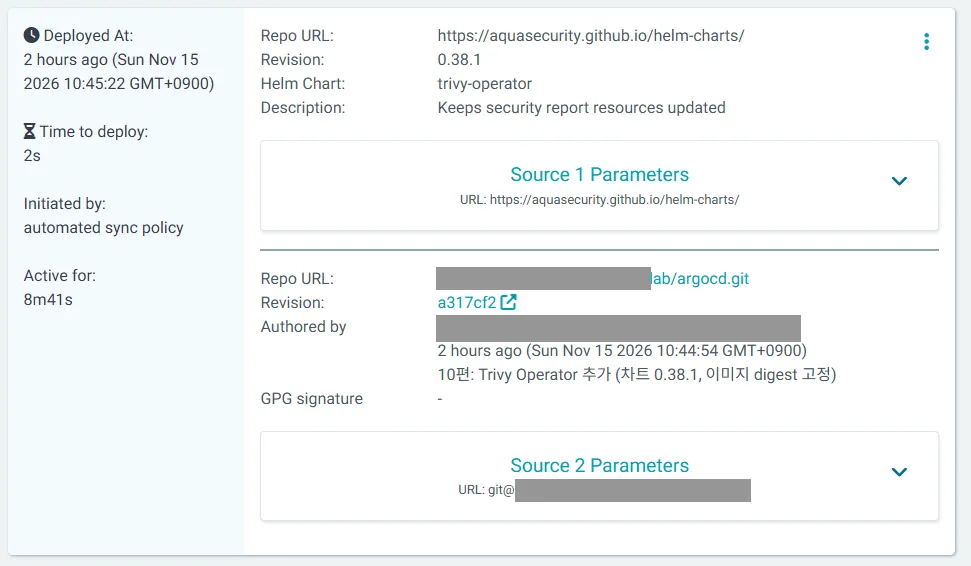
10:44:56에 push하고 루트 Application을 새로고침했습니다. 10:45:24에 OutOfSync가 표시됐고, 10:47:51에 Synced, Healthy가 됐습니다. 설정 감사 보고서는 동기화하자마자 100개가 한꺼번에 생겼고, 취약점 보고서는 스캔 잡이 하나씩 처리하느라 천천히 늘었습니다.
기본 Standalone 방식의 두 문제와 내장 서버 전환
스캔 잡 파드를 열어 보니 맨 처음 실행되는 컨테이너(init)가 매번 취약점 DB를 받고 있었습니다.
trivy --cache-dir /tmp/trivy/.cache image --download-db-only \ --db-repository mirror.gcr.io/aquasec/trivy-db# [vulndb] Downloading vulnerability DB... (잡마다 134MiB)차트 기본값인 Standalone 방식은 스캔 잡마다 DB를 따로 받습니다. 잡 3개를 동시에 돌려도 30초에 보고서 12개가 나오는 속도였고, 이미지가 30개를 넘으니 DB만 몇 GB를 받는 셈이었습니다. 컨테이너가 여러 개인 파드는 더 문제였습니다. Envoy나 Grafana처럼 컨테이너가 23개인 파드는 스캔 자체가 실패했습니다.
ERROR Failed to acquire cache or database lockFATAL Fatal error run error: image scan error: scan error: unable to initialize a scan service: unable to initialize cache: unable to initialize fs cache: cache may be in use by another process: timeout스캔 잡 하나 안에서 컨테이너마다 Trivy가 동시에 실행되면서, 모두 같은 파일 캐시(BoltDB)를 열려다 잠금이 걸린 것입니다. Trivy 문제 해결 문서에도 여러 프로세스가 파일 캐시 하나를 함께 쓰면 잠금 오류가 난다고 나와 있습니다. 클러스터 안에 Trivy 서버를 두는 방식(ClientServer)으로 바꾸면 해결되고, values는 한 줄만 바꾸면 됩니다.
operator: scanJobsConcurrentLimit: 3 builtInTrivyServer: true# → 차트가 StatefulSet trivy-server(PVC 5Gi), Service trivy-service:4954를 추가# → trivy.mode: ClientServer, 스캔 잡은 서버에 물어보기만 함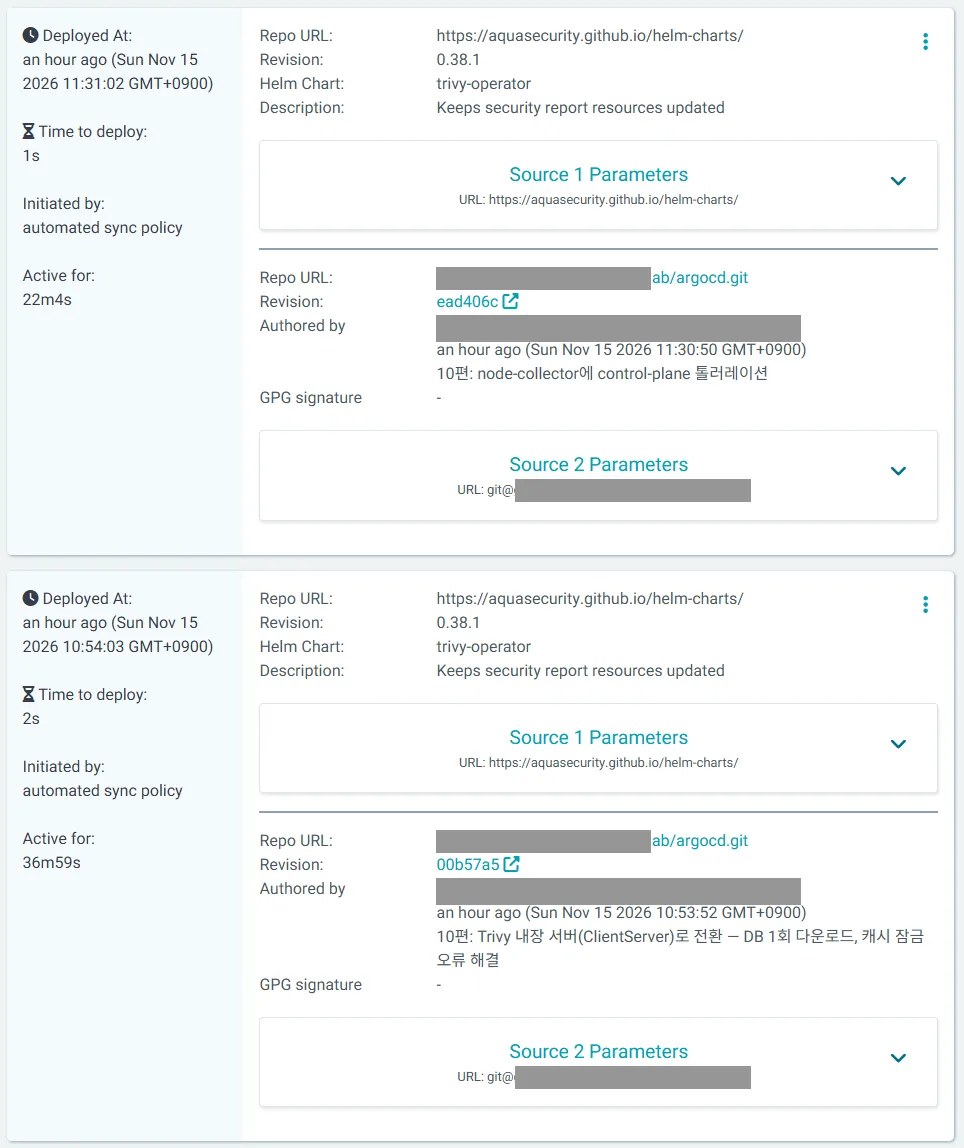
서버는 처음 시작할 때 DB를 한 번만 받았습니다(14초). 두 방식을 비교하려고 기존 보고서를 모두 지우고 처음부터 다시 스캔했습니다.
Standalone과 내장 서버 방식 비교(이 클러스터, 동시 잡 3개)
| 구분 | Standalone(차트 기본) | 내장 Trivy 서버 |
|---|---|---|
| DB 다운로드 | 스캔 잡마다 134MiB | 서버가 한 번(PVC에 보관) |
| 전체 스캔 | 8분 동안 보고서 23개, 일부 실패 | 약 6분(357초)에 보고서 51개 |
| 다중 컨테이너 파드 | 캐시 잠금 오류로 실패 | 정상 |
| Operator 오류 로그 | 스캔 실패 반복 | 0건 |
| 추가 자원 | 없음 | StatefulSet 1개 + PVC 5Gi |
보고서는 워크로드마다가 아니라 컨테이너마다 하나씩 생깁니다. 그래서 워크로드는 36개인데 보고서는 51개가 나왔습니다.
노드 점검이 멈춘 이유: 제어 플레인 테인트
서버 방식으로 바꾼 뒤에도 스캔 잡 하나가 35분 넘게 Pending으로 남아 있었습니다. 노드 설정을 모으는 node-collector 잡이었습니다.
kubectl -n trivy-system describe pod node-collector-...# Node-Selectors: kubernetes.io/hostname=lab-control-plane# Warning FailedScheduling 0/3 nodes are available:# 1 node(s) had untolerated taint(s), 2 node(s) didn't match Pod's node affinity/selector.node-collector는 노드마다 하나씩, 그 노드에 고정돼서 뜹니다. 그런데 제어 플레인 노드에는 일반 파드가 올라오지 못하게 막는 테인트(node-role.kubernetes.io/control-plane:NoSchedule)가 있고, 차트 기본값에는 이를 허용하는 설정이 없습니다. 게다가 동시에 하나만 돌 수 있어서, 이 잡이 자리를 계속 차지하고 있었습니다. values에 톨러레이션을 넣었습니다.
nodeCollector: tolerations: - key: node-role.kubernetes.io/control-plane operator: Exists effect: NoScheduleGit에 반영되고 Operator 설정(ConfigMap)에도 값이 들어갔는데, 새로 만들어진 잡에는 여전히 톨러레이션이 없었습니다. Operator 파드를 한 번 재시작하고 걸려 있던 잡을 지우자, 13초 만에 노드 3개의 점검 보고서가 생겼습니다. Operator가 시작할 때만 설정을 읽는 것으로 보입니다. values를 바꿨는데 결과가 그대로라면 Operator를 재시작했는지부터 확인해 보세요.
노드 점검 결과(kind 노드 이미지 기본값)
| 노드 | 결과 | 주요 지적 |
|---|---|---|
| lab-control-plane | CRITICAL 1, HIGH 3, LOW 1 | 인증 기관(CA) 파일 권한 600 초과, CNI 설정 파일 권한, etcd 데이터 디렉터리 소유자 |
| lab-worker, lab-worker2 | 각 HIGH 2 | kubelet 서비스 파일·config.yaml 권한 |
모두 kind 노드 이미지의 기본 파일 권한이라 실습에서는 고치지 않았습니다. 운영 클러스터라면 노드 이미지를 만들 때 맞춰 두는 항목입니다.
처음 전체 스캔 결과 읽기
보고서도 일반 쿠버네티스 리소스라서 kubectl로 바로 볼 수 있습니다.
kubectl get vulnerabilityreports -Akubectl get vulnerabilityreports -A -o json | jq -r '.items[] | "\(.report.summary.criticalCount) \(.report.summary.highCount) \(.metadata.namespace)/\(.report.artifact.repository):\(.report.artifact.tag)"' | sort -nr | headCritical이 있는 이미지(1~9편 클러스터)
| 네임스페이스 | 이미지 | Critical | High |
|---|---|---|---|
| kube-system | kindest/kindnetd(kind 기본 CNI) | 2 | 13 |
| keycloak | cloudnative-pg/postgresql:18.6-system-trixie(7편) | 1 | 32 |
| logging | fluent/fluent-bit:5.1.3(5편) | 1 | 0 |
| loki | nginxinc/nginx-unprivileged:1.31-alpine(Loki 게이트웨이) | 1 | 3 |
노출된 비밀값 2건은 둘 다 7편 PostgreSQL 이미지 안의 /etc/ssl/private/ssl-cert-snakeoil.key였습니다. 데비안 ssl-cert 패키지가 설치될 때 자동으로 만드는 자체 서명 키로, 이 클러스터에서 쓰는 비밀값은 아닙니다. 그래도 이미지 안에 개인 키가 들어 있는 것은 사실이니 Trivy가 잘못 잡은 것은 아닙니다. 이런 항목은 확인한 뒤 예외로 등록해 둡니다.
설정 감사는 합쳐서 HIGH 53개, MEDIUM 113개, LOW 254개였고 CRITICAL은 없었습니다. 자주 나온 지적은 다음과 같습니다.
- KSV-0125, 신뢰하는 레지스트리만 쓰도록 제한하지 않음(49개): 레지스트리 허용 목록을 정하기 전까지는 계속 나옵니다.
- KSV-0011 CPU 제한 없음(49개), KSV-0018 메모리 제한 없음(30개): 차트 기본값에 자원 제한이 비어 있는 경우가 많습니다.
- KSV-0020, 0021 UID와 GID가 10000 이하(각 38개): 이미지가 정해 둔 사용자 번호를 그대로 쓰면 나옵니다.
- KSV-0118 기본 securityContext 사용(21개, HIGH), KSV-0014 루트 파일 시스템에 쓰기 가능(16개, HIGH)
읽는 순서
숫자가 많을 때는 Critical 취약점, 노출된 비밀값, HIGH 설정 순서로 봅니다. 그다음 내가 만든 앱인지, 차트나 운영자(Operator)가 만든 것인지 나눕니다. 차트가 만든 것이라면 values로 고칠 수 있는지부터 확인합니다.
Grafana 대시보드와 경보 붙이기
Operator는 ServiceMonitor로 trivy_image_vulnerabilities, trivy_resource_configaudits, trivy_image_exposedsecrets 같은 지표를 내보냅니다. 지표의 namespace 라벨에는 Operator가 아니라 스캔한 워크로드의 네임스페이스가 들어갑니다. 덕분에 경보 문구에 “어느 네임스페이스의 어떤 이미지”인지 바로 넣을 수 있습니다.
대시보드는 Trivy Operator 문서에서 안내하는 grafana.com 17813번을 썼습니다. JSON을 받아 데이터 소스 변수 ${DS_PROMETHEUS}를 kube-prometheus-stack의 기본 데이터 소스 uid인 prometheus로 바꾸고, ConfigMap에 넣어 Git에 커밋했습니다.
# platform/trivy-config/grafana-dashboard.yaml (요약)apiVersion: v1kind: ConfigMapmetadata: name: trivy-operator-dashboard namespace: monitoring labels: grafana_dashboard: "1" # Grafana 사이드카가 찾는 라벨data: trivy-operator.json: | { ... 대시보드 JSON ... }Grafana는 다시 배포하지 않았습니다. kube-prometheus-stack의 Grafana 파드에는 grafana-sc-dashboard라는 사이드카 컨테이너가 함께 떠 있습니다. 이 사이드카가 grafana_dashboard: "1" 라벨이 붙은 ConfigMap을 지켜보다가, 새로 생기면 내용을 Grafana 대시보드 폴더에 파일로 써 줍니다. Grafana는 그 파일을 읽어 대시보드를 등록합니다. 이번에도 ConfigMap이 생기자마자 사이드카 로그에 Writing /tmp/dashboards/trivy-operator.json이 찍혔고, Grafana 컨테이너는 재시작되지 않았습니다. 5편에서 Loki 데이터 소스를 붙일 때도 같은 방식(grafana_datasource 라벨)을 썼습니다.
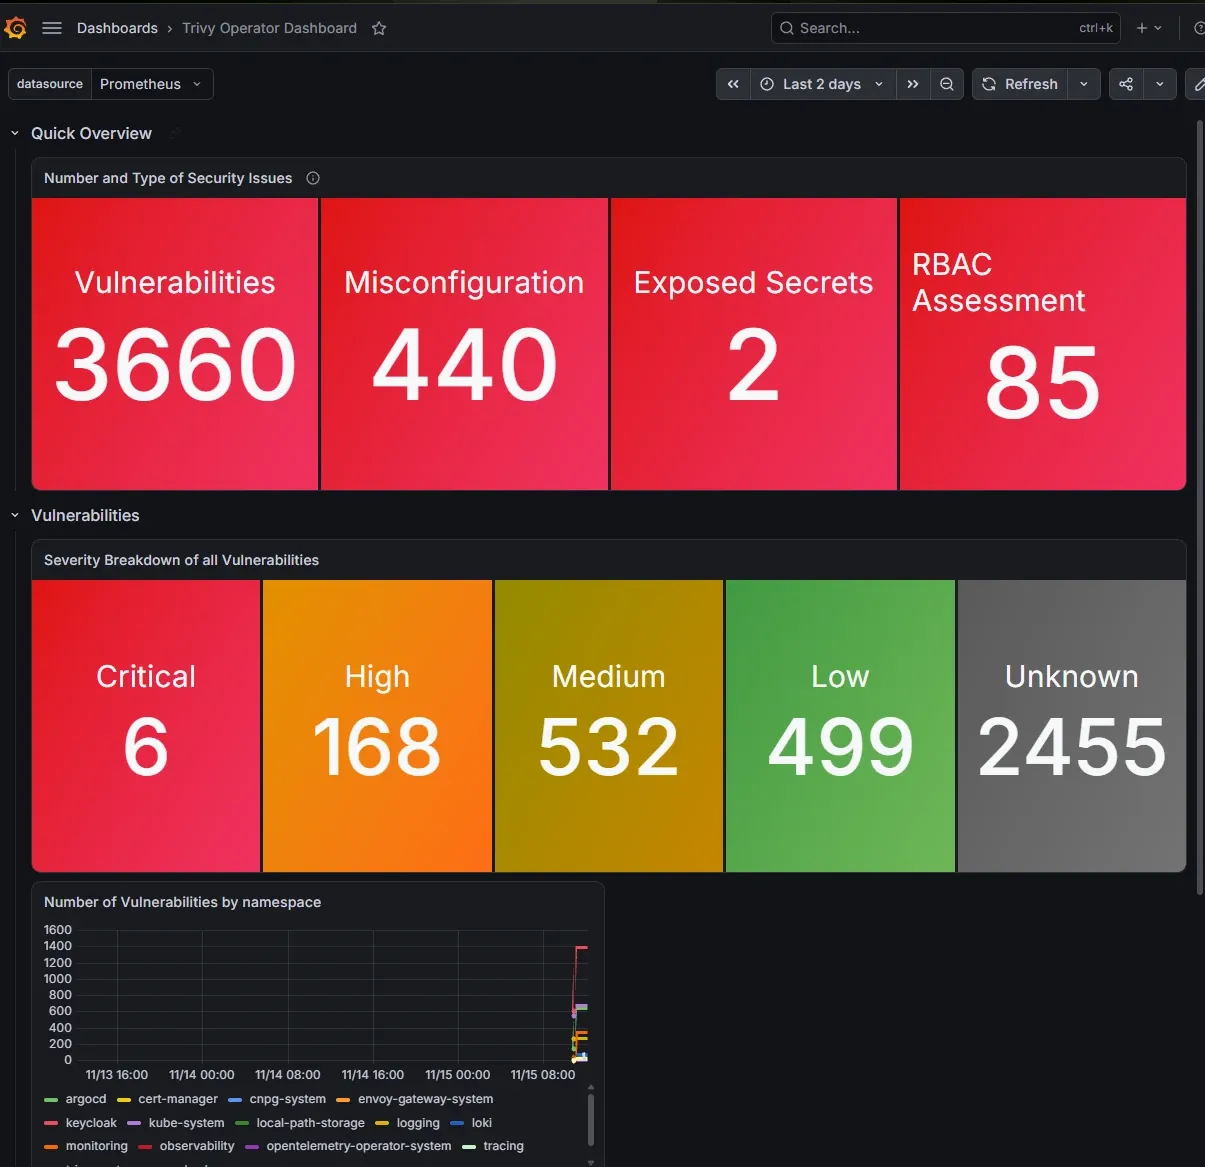
대시보드 첫 화면을 보면 취약점이 3660개, 설정 지적이 440개, 노출된 비밀값이 2개, RBAC 지적이 85개입니다. 심각도별로는 Unknown이 2455개로 가장 많고, Critical은 6개, High는 168개입니다. Unknown은 취약점 DB에 아직 심각도 점수가 매겨지지 않은 항목입니다. 그래서 전체 숫자보다는 Critical, High와 고친 버전이 있는지를 기준으로 보는 것이 좋습니다. 대시보드는 2023년에 올라온 버전이지만, 지표 이름이 지금 Operator와 같아서 그대로 동작했습니다.
경보는 PrometheusRule로 3개를 만들었습니다. 6편 인증서 경보처럼 release: kps 라벨을 붙여야 Prometheus가 읽어 갑니다.
- alert: TrivyCriticalVulnerability expr: sum by (namespace, resource_kind, resource_name, image_repository, image_tag) (trivy_image_vulnerabilities{severity="Critical"}) > 0 for: 5m- alert: TrivyExposedSecret expr: sum by (namespace, resource_kind, resource_name, image_repository, image_tag) (trivy_image_exposedsecrets) > 0 for: 5m- alert: TrivyOperatorAbsent # Operator가 멈추면 아무도 모름 expr: absent(up{job="trivy-operator"} == 1) for: 10m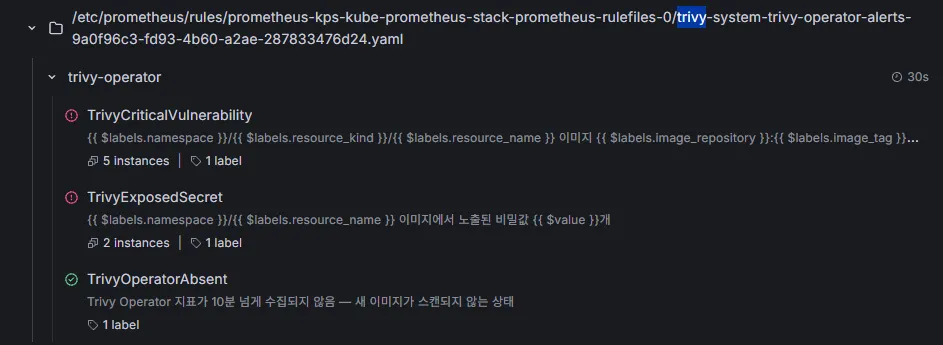
규칙을 올리자마자 이미 떠 있던 이미지 때문에 Critical 경보 5건과 비밀값 경보 2건이 울렸습니다. 대시보드의 Critical은 6개인데 경보가 5건인 것은, 경보를 이미지 단위로 묶었고 kindnet 이미지 하나에 Critical이 2개 있기 때문입니다. 처음 도입하면 경보가 많이 울리는 것이 보통입니다. 하나씩 고치거나 예외로 등록해 0으로 만든 다음부터가 실제 감시입니다.
훈련 1: 오래된 이미지를 Git으로 배포하면
일부러 nginx:1.19-alpine을 쓰는 Deployment(vuln-demo)를 Git에 커밋했습니다. 실제 운영처럼 Argo CD 새로고침 버튼은 누르지 않고 기본 폴링에 맡겼습니다.
훈련 1 타임라인
| 시각 | 경과 | 일어난 일 |
|---|---|---|
| 11:36:13 | 0 | 커밋 push |
| 11:40:31 | +4분 18초 | Argo CD가 새 Application을 만들고 동기화(루트 폴링 + 자식 폴링) |
| 11:40:38 | +4분 25초 | 파드 Running, VulnerabilityReport 생성(Critical 9) |
| 11:40:51 | +4분 38초 | Prometheus 지표에 Critical 9 반영 |
| 11:41:22 | +5분 9초 | 경보 pending |
| 11:45:57 | +9분 44초 | 경보 firing, Alertmanager 도착 |
스캔하고 지표에 반영되는 데는 30초도 걸리지 않았습니다. 대부분의 시간은 Argo CD 폴링(4분 18초)과 경보의 for: 5m 대기(5분)였습니다. 보고서는 파드가 뜨고 몇 초 안에 나왔습니다.
운영 포인트
push부터 경보까지 약 10분 동안 취약한 이미지가 떠 있었습니다. 이 시간을 줄이려면 배포 전에 막는 단계(CI의
--exit-code나 admission 정책)가 있어야 합니다. Operator가 잘하는 일은 이미 떠 있는 이미지와 새로 알려진 취약점을 찾아내는 것입니다.
훈련 2: 태그를 올리는 커밋으로 고치기
Deployment의 이미지를 nginx:1.31-alpine으로 바꾸는 한 줄을 커밋했습니다.
훈련 2 타임라인
| 시각 | 경과 | 일어난 일 |
|---|---|---|
| 11:46:22 | 0 | 커밋 push |
| 11:48:12 | +1분 50초 | Argo CD 동기화, 새 파드 Running |
| 11:48:18 | +1분 56초 | 새 VulnerabilityReport(1.31, Critical 0) |
| 11:48:31 | +2분 9초 | 지표가 1.31 기준으로 바뀌고 1.19 지표 사라짐 |
| 11:49:03 | +2분 41초 | 경보 해제(Prometheus·Alertmanager 모두 0건) |
옛 ReplicaSet(1.19)의 보고서는 지우지 않아도 알아서 사라졌습니다. 차트 기본값 vulnerabilityScannerScanOnlyCurrentRevisions: true 때문에 현재 버전만 점검하기 때문입니다. 고칠 때는 경보 대기 시간이 없어서, 문제가 생길 때보다 훨씬 빨리 정상으로 돌아왔습니다.
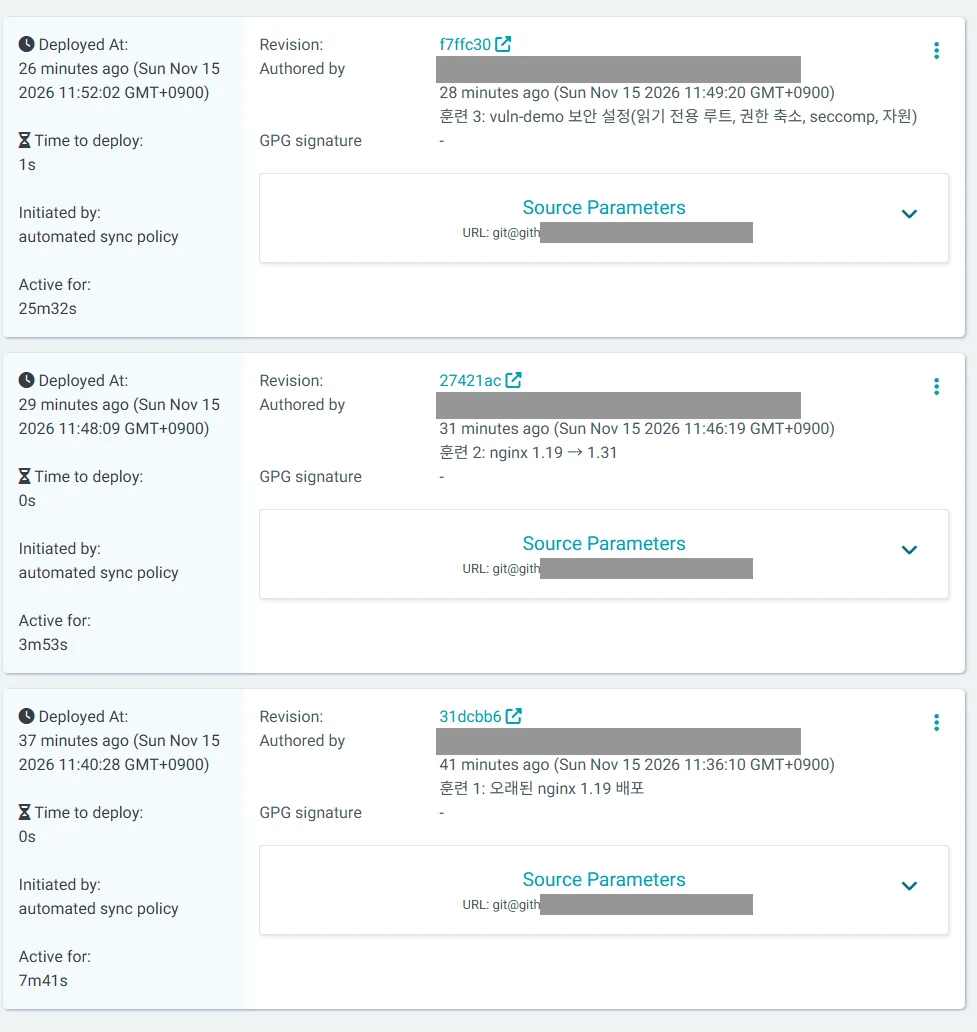
vuln-demo Application의 배포 이력입니다. 아래부터 훈련 1(nginx 1.19 배포), 훈련 2(1.31로 올림), 훈련 3(보안 설정) 커밋이 차례로 반영된 것이 보입니다. 누가 언제 무엇을 바꿨는지 Git 커밋으로 남는다는 점이 9편에서 GitOps로 옮긴 이유이기도 합니다.
훈련 3: 설정 감사 지적 고치기
1.31로 올린 뒤에도 설정 감사(ConfigAuditReport)에는 HIGH 3개, MEDIUM 4개, LOW 10개, 모두 17개의 실패 항목이 남아 있었습니다.
처음에는 root가 아닌 사용자로 도는 nginxinc/nginx-unprivileged:1.31-alpine 이미지로 바꿔 봤습니다. 설정 지적은 2개까지 줄었는데, 이 이미지 자체에 Critical 취약점이 1개 있었습니다(이 클러스터의 Loki 게이트웨이가 쓰는 이미지와 같아서 이미 Critical 경보 대상이었습니다). 설정을 고치려고 이미지를 바꾸면 취약점이 다시 늘 수 있는 것입니다. 그래서 공식 nginx 이미지는 그대로 두고, 이미지를 바꾸지 않아도 되는 설정만 고쳤습니다.
spec: securityContext: seccompProfile: type: RuntimeDefault containers: - name: nginx image: nginx:1.31-alpine securityContext: allowPrivilegeEscalation: false readOnlyRootFilesystem: true capabilities: drop: ["ALL"] add: ["NET_BIND_SERVICE", "SETUID", "SETGID", "CHOWN"] resources: requests: { cpu: 10m, memory: 16Mi } limits: { cpu: 100m, memory: 64Mi } volumeMounts: # 읽기 전용 루트에서 nginx가 쓰는 경로만 열어 줌 - { name: cache, mountPath: /var/cache/nginx } - { name: run, mountPath: /run } - { name: tmp, mountPath: /tmp } volumes: - { name: cache, emptyDir: {} } - { name: run, emptyDir: {} } - { name: tmp, emptyDir: {} }push하고 2분 39초 뒤 Argo CD가 동기화했고, 새 ReplicaSet의 설정 감사 보고서도 같은 시각에 생겼습니다. 설정 감사는 스캔 잡 없이 Operator가 바로 계산하기 때문입니다.
훈련 3 전후 설정 감사
| 구분 | HIGH | MEDIUM | LOW | 실패 항목 |
|---|---|---|---|---|
| 고치기 전 | 3 | 4 | 10 | 17개 |
| 고친 뒤 | 0 | 3 | 3 | 6개 |
남은 6개는 runAsNonRoot 없음, UID와 GID가 10000 이하, 권한(capability) 추가, 1024 미만 포트입니다. 공식 nginx 이미지는 root로 시작해 80번 포트를 연 다음 워커를 nginx 사용자로 바꾸기 때문에 남을 수밖에 없는 지적입니다. 이 6개까지 없애려면 앱 이미지를 바꿔야 해서, 이유를 적어 두고 남겨 뒀습니다.
겪은 문제
읽기 전용 루트로 바꾸고 나서 파드 안에서
wget localhost:80이Connection refused로 실패했습니다. nginx 이미지는 시작할 때 설정 파일에 IPv6 listen 줄을 넣는데, 루트가 읽기 전용이라 이 단계를 건너뛴 것입니다. 그래서 localhost(::1)로는 안 되고127.0.0.1로는 됩니다. Service로 접속할 때는 문제없었습니다.
훈련 4: 취약점 DB를 받을 수 없으면
이번에는 Trivy 서버가 취약점 DB를 받지 못하는 상황을 만들었습니다. values의 trivy.dbRegistry를 존재하지 않는 주소(registry.invalid, 예약된 가짜 도메인)로 바꿔 커밋했습니다.
커밋을 올리고 기다렸지만 아무 일도 없었습니다. 서버가 전에 받아 둔 DB를 그대로 쓰고 있었기 때문입니다. 주소가 틀렸다는 사실은 서버가 DB를 다시 받으려는 순간에야 드러납니다.
그 순간을 만들려고 서버 파드와 디스크(PVC)를 지웠습니다. 서버가 다른 노드로 옮겨 빈 디스크로 다시 뜨는 상황과 같습니다.
kubectl -n trivy-system logs trivy-server-0# FATAL failed to download vulnerability DB: ... registry.invalid/aquasec/trivy-db:2 ...# lookup registry.invalid on <CoreDNS 주소>:53: no such host# → CrashLoopBackOff# 스캔 잡: Post "http://trivy-service.trivy-system:4954/twirp/...": dial tcp ...: connect: connection refused훈련 4에서 보인 것과 안 보인 것
| 확인한 곳 | 결과 |
|---|---|
| Grafana Trivy 대시보드 | 다른 워크로드의 옛 보고서 51개가 그대로라 정상처럼 보임 |
| Trivy 경보 3개 | 모두 조용함(Operator 자체는 살아 있음) |
| 실패한 스캔 잡 | 몇 초 만에 지워져 kube_job_status_failed 지표에도 남지 않음 |
| Operator 지표 | 스캔 실패를 나타내는 항목 없음 |
| kube-prometheus-stack 기본 경보 | KubePodNotReady, KubePodCrashLooping이 trivy-server-0으로 pending(기본 15분 뒤 firing) |
Git에서 되돌리는 커밋을 push하자 3분 26초 뒤 설정이 돌아왔습니다. CrashLoopBackOff 대기 시간 때문에 서버가 Ready가 되기까지 50초쯤 더 걸렸습니다. 그런데 서버가 살아난 뒤에도 실패했던 스캔은 다시 돌지 않았습니다. 17분 동안 그 워크로드의 보고서가 비어 있다가, Operator 파드를 재시작하자 13초 만에 다시 생겼습니다.
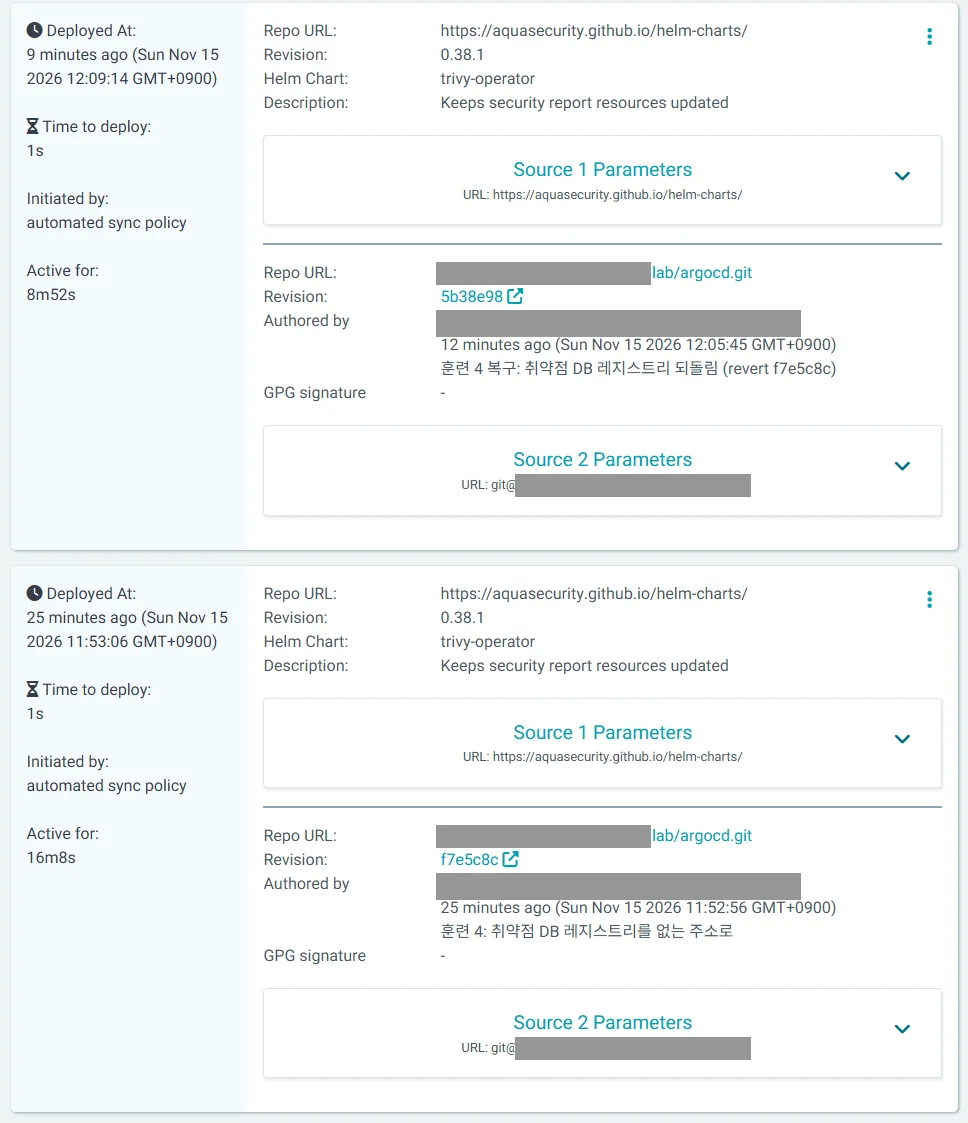
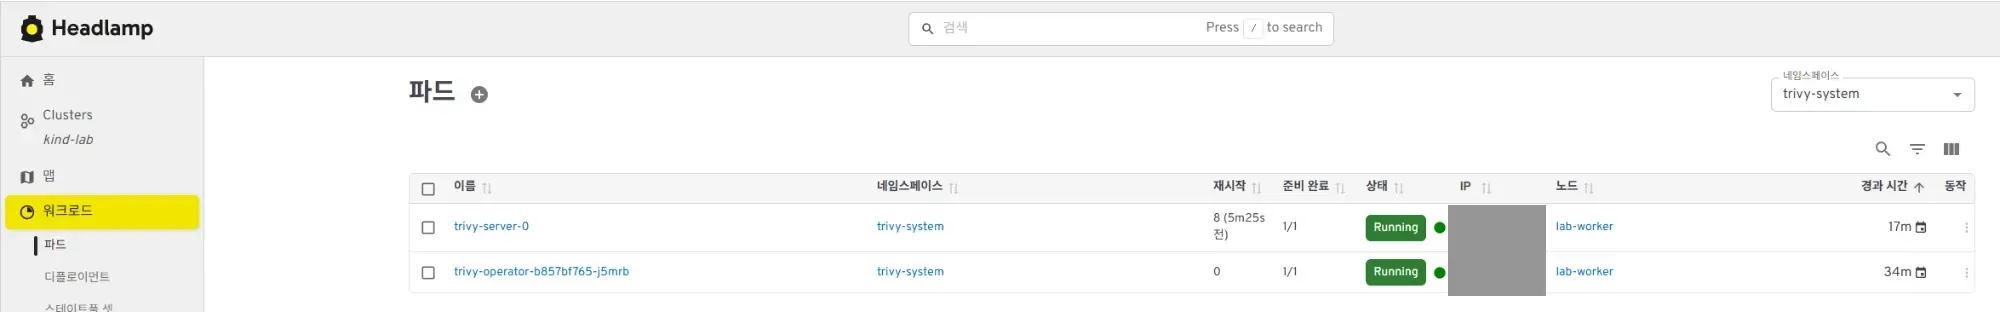
장애 커밋(f7e5c8c)과 복구 커밋(5b38e98)의 배포 이력, 그리고 복구한 뒤 Headlamp에서 본 trivy-system 파드입니다. trivy-server-0의 재시작 8회가 이번 훈련에서 생긴 것입니다.
교훈
스캔이 실패해도 겉으로는 새 보고서가 안 생기는 것밖에 보이지 않습니다. Trivy 서버 파드 상태 경보(KubePodNotReady 등)를 Trivy 담당자도 받게 하고, 복구한 뒤에는 Operator를 재시작하거나 보고서가 다시 생겼는지 확인하는 단계를 복구 절차에 넣어 두세요. 이번 장애는 약 18분 이어졌는데, 그동안 대시보드만 봐서는 알 수 없었습니다.
운영 체크리스트
이번 실습에서 확인한 내용을 운영할 때 챙길 항목으로 정리했습니다.
- Trivy 자체를 먼저 확인하세요. CLI와 이미지는 체크섬과 cosign 서명을 확인하고
태그@digest로 고정합니다. CI의 GitHub Action은 커밋 SHA로 고정합니다. - 배포 전에 막는 단계를 두세요. CI에서
trivy image --exit-code 1 --severity CRITICAL과trivy config --exit-code 1을 실행합니다. Operator는 배포를 막지 않습니다. - 이미지가 수십 개를 넘거나 컨테이너가 여러 개인 파드가 있으면 내장 Trivy 서버(
builtInTrivyServer: true)를 쓰세요. PVC 5Gi가 하나 늘어납니다. - 제어 플레인에 테인트가 있다면
nodeCollector.tolerations를 넣고, 값을 바꾼 뒤에는 Operator가 재시작됐는지 확인하세요. - 경보는 Critical 취약점, 노출된 비밀값, Operator 부재 세 가지로 시작하고, Trivy 서버 파드 상태 경보도 함께 받으세요.
- 고칠 수 없거나 실제로 위험하지 않은 항목은 차트 값
trivy.ignoreFile(CVE ID 목록) 같은 방법으로 이유와 함께 예외 처리하세요. 경보가 늘 울리면 결국 아무도 보지 않게 됩니다. - 보고서는 차트 기본값(
scannerReportTTL: 24h)에 따라 하루마다 지워지고 다시 스캔됩니다. 새로 알려진 CVE는 이때 반영됩니다. - CIS, NSA, PSS 같은 컴플라이언스 보고서는 기본 6시간마다(
0 */6 * * *) 만들어집니다. 설치 직후에는 비어 있어도 정상입니다.
자주 묻는 질문
Trivy Operator를 설치하면 취약한 이미지 배포가 막히나요?
막히지 않습니다. Trivy Operator는 떠 있는 워크로드를 스캔해서 보고서와 지표를 남기기만 합니다. 배포를 막고 싶다면 CI에서 Trivy CLI의 `—exit-code`를 쓰거나, 클러스터에 admission 정책 도구를 따로 둬야 합니다.
대시보드에 Unknown 심각도가 가장 많은데 무시해도 되나요?
Unknown은 취약점 DB에 아직 심각도 점수가 없는 항목입니다. 위험하지 않다는 뜻은 아니지만, 무엇부터 처리할지 정할 근거가 부족합니다. Critical, High와 고친 버전이 있는 항목을 먼저 처리하고, Unknown은 이미지를 정기적으로 새로 빌드하면서 함께 줄여 가는 것이 현실적입니다.
Standalone과 내장 서버 방식 중 무엇을 써야 하나요?
이미지가 적고 파드마다 컨테이너가 하나뿐이라면 기본값인 Standalone으로도 충분합니다. 이번 실습처럼 이미지가 30개를 넘고 컨테이너가 여러 개인 파드가 있다면 내장 서버 방식을 추천합니다. 스캔 잡마다 DB를 받는 부담과 캐시 잠금 오류가 사라집니다. 대신 서버 StatefulSet과 PVC가 하나씩 늘고, 서버가 멈추면 모든 스캔이 함께 멈춥니다.
Trivy CLI와 Operator 중 하나만 쓴다면 무엇을 고르나요?
새 배포를 막는 것이 목표라면 CI에서 쓰는 CLI가 먼저입니다. 이미 떠 있는 이미지에서 새로 알려진 취약점을 찾는 것이 목표라면 Operator가 필요합니다. Operator만 쓰면 이번 훈련 1처럼 경보가 올 때까지 약 10분 동안 취약한 이미지가 떠 있게 됩니다.
작성 방식과 다음 편
이 글에 나온 명령, 오류 메시지, 측정값은 모두 1편의 실습 PC에서 직접 실행한 결과이고, 설정은 Trivy, Trivy Operator, Argo CD 공식 문서와 차트 기본값을 기준으로 했습니다. 화면에 보이던 계정 이름, 이메일, IP는 가렸고, 실행 기록을 정리하고 글을 쓰는 데 AI 도구를 함께 썼습니다. 이번 편으로 9편까지 쌓은 클러스터의 이미지와 설정, 노드를 꾸준히 점검할 수 있게 됐습니다. 다음 편에서는 서비스 메시 Istio(Ambient 모드)를 다룰 예정입니다.