Strimzi로 쿠버네티스에 Kafka 올리기: KRaft 브로커 3대, SCRAM·ACL, 소비 지연 경보와 장애·업그레이드 훈련까지 kind 실습
Kafka가 무엇을 하는지 결제 예시로 먼저 정리하고, Strimzi로 브로커 3대를 올린 뒤 브로커를 죽이고, 업그레이드하고, 파티션을 늘리며 메시지가 어디서 빠지는지 직접 센 기록
로컬 쿠버네티스 실습 시리즈 목차 · 글 15개
- 1편Windows에서 무료 쿠버네티스 실습 환경 만들기: WSL2 + Docker Engine + kind
- 2편Headlamp 설치와 사용법: 로컬 쿠버네티스를 화면으로 보고 파드 배포하기
- 3편NGINX Ingress 대신 Gateway API: kind 클러스터 앱을 Windows localhost로 접속하기
- 4편kube-prometheus-stack 설치와 Grafana 접속: kind 클러스터 모니터링과 target down 해결
- 5편Fluent Bit과 Loki로 쿠버네티스 로그 모으기: kind 실습과 Grafana 조회, AWS 확장 예시
- 6편cert-manager로 Gateway API HTTPS 붙이기: 사설 CA, 자동 갱신, 만료 알림까지 kind 실습
- 7편Keycloak 운영 모드로 Grafana SSO 만들기: Keycloak Operator, CloudNativePG, 이중화와 장애·백업 훈련
- 8편OpenTelemetry로 쿠버네티스 트레이스 모으기: Collector, Tempo, 샘플링과 장애 훈련까지 kind 실습
- 9편Argo CD로 쿠버네티스 GitOps 전환하기: Helm 설치 넘겨받기, Sealed Secrets, Keycloak SSO와 장애 훈련까지 kind 실습
- 부록Argo CD로 nginx 파드 하나 배포하기: GitHub에서 파일 두 개 커밋하고 replicas 바꿔 보기
- 10편Trivy Operator로 쿠버네티스 취약점 점검하기: 이미지·설정·비밀값 스캔, Grafana 경보, Argo CD로 고치기까지 kind 실습
- 번외편Trivy로 찾은 컨테이너 이미지 취약점 고치기: nginx apk upgrade, Go 의존성 올리기, Grafana처럼 직접 못 고치는 경우까지
- 11편Istio Ambient 모드로 서비스 메시 붙이기: 사이드카 없이 mTLS, 권한 정책, waypoint 트래픽 분할과 장애 훈련까지 kind 실습
- 12편Strimzi로 쿠버네티스에 Kafka 올리기: KRaft 브로커 3대, SCRAM·ACL, 소비 지연 경보와 장애·업그레이드 훈련까지 kind 실습
- 13편Airflow를 쿠버네티스에 올리기: KubernetesExecutor, git-sync DAG 배포, 재시도·catchup부터 스케줄러 장애와 3.4 업그레이드까지 kind 실습
Kafka는 한 서비스가 “이런 일이 일어났다”는 메시지를 써 두면, 그 일을 이어받을 여러 서비스가 각자 가져가서 처리하게 해 주는 메시지 저장소입니다. 받는 쪽이 잠깐 죽어 있어도 메시지가 남아 있어서, 살아나면 멈춘 곳부터 이어서 처리할 수 있습니다. 이번 편에서는 먼저 결제 예시로 토픽, 파티션, 브로커, 오프셋을 정리하고, 9편까지 만든 클러스터에 Strimzi 1.3.1과 Kafka 4.3(브로커 3대)을 Argo CD로 설치했습니다. 그다음 초당 10건을 보내는 생산자와 받는 소비자를 띄워 두고 브로커 강제 종료, 브로커 2대 정지, 롤링 업그레이드, 소비자 정지, 권한(ACL) 거절, 파티션 늘리기를 시험하면서, 메시지가 몇 건 빠지고 몇 초 멈추는지 번호로 셌습니다. 오류가 하나도 없는데 1,000건을 건너뛰는 함정도 하나 찾았습니다.
1~11편에서 만든 kind 클러스터(노드 3개, kube-prometheus-stack, Argo CD로 Git 관리)를 이어서 씁니다. Strimzi 1.3.1(Helm OCI 차트)과 Kafka 4.3.1을 설치한 뒤 훈련에서 4.3.2로 올렸고, Kafka UI(kafbat v1.5.0)를 붙였습니다. Kafka UI는 로그인 없이 읽기 전용으로 두고 port-forward로만 열었습니다. 11편의 Istio 메시에는 넣지 않았습니다. 마지막에 AWS의 관리형 Kafka(MSK)에서는 같은 것을 어떤 지표로 보는지도 정리했습니다.
Kafka는 무엇을 하나: 결제 예시로 먼저 보기
Kafka를 설치하기 전에, Kafka가 실제 서비스에서 어떤 자리에 들어가는지부터 보겠습니다. 쇼핑몰에서 고객이 결제를 마치면 배송, 알림, 포인트, 통계 서비스가 모두 그 사실을 알아야 합니다.
Kafka 없이: 결제 서버가 하나하나 직접 부른다
%% 제목: Kafka 없이 결제 서버가 배송·알림·포인트 서버를 HTTP로 하나씩 직접 부르는 구조
flowchart LR
  user["고객"] --> pay["결제 서버"]
  pay -- "HTTP" --> ship["배송 서버"]
  pay -- "HTTP" --> noti["알림 서버"]
  pay -- "HTTP" --> point["포인트 서버"]
Kafka를 쓰면: 결제 서버는 한 번 쓰고 끝, 나머지는 각자 가져간다
%% 제목: 결제 서버가 Kafka payments 토픽에 결제 완료 메시지를 한 번 쓰면 배송·알림·포인트 서버가 각자 가져가 처리하는 구조
flowchart TB
  user["고객"] --> pay["결제 서버"]
  pay -- "결제 123 완료" --> kafka[("Kafka<br/>payments 토픽")]
  kafka -- "가져가서 출고 지시" --> ship["배송 서버"]
  kafka -- "가져가서 문자 발송" --> noti["알림 서버"]
  kafka -- "가져가서 적립" --> point["포인트 서버"]
직접 부르는 방식에서는 알림 서버가 느리거나 죽어 있으면 결제 응답도 늦어지거나 실패합니다. 받는 곳이 하나 늘 때마다 결제 서버 코드도 고쳐야 합니다. Kafka를 사이에 두면 결제 서버는 메시지 한 건을 쓰고 바로 고객에게 응답합니다. 알림 서버가 10분 동안 죽어 있어도 메시지는 Kafka에 남아 있어서, 살아나면 놓친 것부터 처리합니다.
헷갈리기 쉬운 세 가지
| 질문 | 답 |
|---|---|
| 웹페이지가 Kafka에 직접 넣나요? | 아니요. 브라우저는 평소처럼 결제 서버에 HTTP로 요청하고, Kafka에 쓰는 것은 결제 서버 코드입니다. 카드 승인처럼 고객이 기다려야 하는 일은 Kafka 없이 바로 처리하고, 그 결과(“결제가 끝났다”)를 Kafka에 넣습니다. |
| 로그를 저장하는 건가요? | 아닙니다. 로그는 사람이 문제를 볼 때 쓰는 기록이고, Kafka 메시지는 다른 프로그램이 받아서 일을 하라고 보내는 데이터입니다. 앱 코드에서 Kafka 라이브러리로 직접 보냅니다. |
| Kafka가 DB 데이터를 가져가나요? | 보통은 아닙니다. 결제 서버가 DB에도, Kafka에도 따로 씁니다. DB가 진짜 기록이고, Kafka 메시지는 보관 기간(보통 며칠)이 지나면 지워집니다. DB 변경 내용을 Kafka로 옮기는 구성(CDC)도 있지만, 그때도 DB를 읽는 것은 Debezium 같은 별도 프로그램입니다. |
결제 서버 쪽 코드는 대략 이런 모양입니다. 아래는 이해를 돕기 위한 예시이고 이번 실습에서 실행한 코드는 아닙니다. 핵심은 Kafka 주소(bootstrap servers)와 계정 정보를 설정에 적고, 일을 마친 뒤 토픽 이름을 지정해 보낸다는 점입니다.
# 예시(Python, kafka-python). 주소와 비밀번호는 코드에 넣지 않고 환경 변수로 받는다producer = KafkaProducer(    bootstrap_servers=os.environ["KAFKA_BOOTSTRAP"],   # 예: lab-kafka-bootstrap.kafka:9093    security_protocol="SASL_SSL",    sasl_mechanism="SCRAM-SHA-512",    sasl_plain_username="producer",    sasl_plain_password=os.environ["KAFKA_PASSWORD"],    ssl_cafile="/ca/ca.crt",    acks="all",)
def payment_done(order_id, amount):    db.save(order_id, amount)                               # ① DB에 진짜 기록    producer.send("payments", key=str(order_id).encode(),   # ② 다른 서비스에 알림                  value=json.dumps({"orderId": order_id, "amount": amount}).encode())
주소는 하나만 적어도 됩니다. 클라이언트는 처음 붙은 브로커에게서 “브로커가 몇 대 있고, 어느 파티션의 리더가 누구인지”를 받아 온 뒤 필요한 브로커에 직접 붙습니다. 그래서 브로커가 바뀌어도 앱 설정을 고칠 필요가 없습니다.
토픽, 파티션, 브로커, 오프셋
Kafka 문서와 화면에 계속 나오는 네 단어입니다. 도서관에 비유하면 이해하기 쉽습니다.
네 가지 개념
| 말 | 비유 | 뜻 | 이번 실습 |
|---|---|---|---|
| 브로커 | 도서관 건물 | 메시지를 받아 디스크에 저장하고 내어 주는 Kafka 서버 한 대 | lab-dual-0, 1, 2 (3대) |
| 토픽 | 책 시리즈 이름 | 메시지를 종류별로 나누는 이름. 생산자와 소비자는 토픽 이름으로만 말함 | orders |
| 파티션 | 시리즈의 1권, 2권, 3권 | 토픽을 나눈 실제 저장 칸. 칸 안에서만 순서가 보장되고, 칸 수가 동시에 읽을 수 있는 소비자 수의 상한 | 3 → 6 → 9개로 늘림 |
| 오프셋 | 쪽 번호와 책갈피 | 파티션 안 메시지 번호(0, 1, 2…). 소비자 그룹이 어디까지 읽었는지도 오프셋으로 기록 | Kafka UI의 Current Offset |
파티션마다 복사본을 여러 브로커에 나눠 둡니다(복제). 복사본 중 하나가 리더로서 읽기와 쓰기를 받고, 나머지(팔로워)는 리더를 따라 적습니다. 리더를 잘 따라잡고 있는 복사본 목록을 ISR(In-Sync Replicas)이라고 부릅니다.
orders 토픽(파티션 3개, 복제 3) 배치 예              브로커 0           브로커 1           브로커 2orders-0   :  ★리더              팔로워             팔로워orders-1   :  팔로워             ★리더              팔로워orders-2   :  팔로워             팔로워             ★리더
리더가 있는 브로커가 죽으면 → 팔로워 중 하나가 새 리더가 된다
오프셋은 두 가지 의미로 쓰입니다. 하나는 메시지가 파티션의 몇 번째 칸에 적혔는지이고, 다른 하나는 소비자 그룹이 “여기까지 읽었다”고 Kafka에 적어 둔 책갈피(커밋된 오프셋)입니다. 소비자가 죽었다 살아나면 이 책갈피부터 이어 읽습니다. 책갈피는 그룹마다 따로 있어서 배송 그룹과 알림 그룹이 같은 메시지를 각자 읽습니다.
파티션 5... 25838 25839 25840 | 25841 ... 25869 | ← 다음 메시지가 들어갈 자리(끝 오프셋) 25870 ↑ 소비자 그룹의 책갈피 25840지연(lag) = 끝 오프셋 − 책갈피 = 30건 ← 아직 못 읽은 양지연(lag)은 Kafka 운영에서 가장 많이 보는 숫자입니다. 계속 늘어나면 소비자가 들어오는 속도를 못 따라가는 것입니다. 이번 실습에서는 지연이 500건을 넘으면 경보가 울리게 했습니다.
Kafka를 쓰는 전체 흐름
개념을 한 줄로 이으면 다음과 같습니다. 이번 편의 실습도 이 순서로 진행했습니다.
- 준비: 브로커 여러 대로 클러스터를 만들고, 토픽(파티션 수, 복제 수)과 계정·권한을 정합니다.
- 보내기: 생산자가 메시지를 보내면 키에 따라 파티션이 정해지고, 그 파티션의 리더가 받아 팔로워에게 복사합니다.
acks=all이면 정해진 수(min.insync.replicas)만큼 적힌 뒤에 성공 응답이 갑니다. - 보관: 메시지는 읽어도 지워지지 않고, 보관 기간이나 용량을 넘으면 오래된 것부터 지워집니다.
- 받기: 소비자 그룹 안에서 파티션을 나눠 맡고, “가져오기 → 처리 → 책갈피 기록”을 반복합니다. 소비자가 죽거나 늘면 파티션을 다시 나눕니다(리밸런스).
- 운영: 지연, 복제 상태, 브로커 수를 지켜보고, 소비자를 늘리거나 브로커를 한 대씩 업그레이드합니다.
Kafka를 쓰면 누락이 없어지나
Kafka는 후속 처리가 빠지지 않도록 메시지를 붙잡아 두는 장치이지만, 저절로 유실이 0이 되지는 않습니다. 보내는 쪽이 재시도 끝에 포기하거나, 받는 쪽이 책갈피를 잘못 잡으면 메시지가 빠집니다. 이번 훈련에서 실제로 두 번 빠졌고, 어디서 빠졌는지는 아래에서 숫자로 보여 드립니다.
이번 편에서 만드는 구성
Kafka는 브로커 여러 대, 디스크, 인증서, 계정, 순서 있는 재시작까지 신경 쓸 것이 많습니다. Strimzi는 이 일을 맡아 주는 쿠버네티스 운영자(Operator)입니다. Kafka, KafkaNodePool, KafkaTopic, KafkaUser 같은 YAML을 Git에 적으면 Strimzi가 그 상태로 맞춥니다. 그래서 9편의 Argo CD GitOps와 잘 맞습니다.
12편 구성 요소
| 구성 요소 | 역할 |
|---|---|
| Strimzi 운영자 1.3.1 | Kafka 관련 YAML을 보고 브로커 파드, 인증서, 설정, 재시작 순서를 관리 |
| Kafka 4.3(lab-dual-0~2) | 브로커와 컨트롤러를 겸하는 파드 3개(KRaft, ZooKeeper 없음)를 노드마다 하나씩 |
| Entity Operator | KafkaTopic, KafkaUser YAML을 실제 토픽과 계정(SCRAM 비밀번호, ACL)으로 만듦 |
| Kafka Exporter | 파티션 리더, ISR, 소비 지연 같은 지표를 Prometheus로 내보냄 |
| orders-producer, orders-consumer | 훈련용 생산자와 소비자. 초당 10건을 보내고 받음 |
| Kafka UI(kafbat) | 브로커, 토픽, 소비자 그룹 지연을 웹 화면으로 확인(읽기 전용) |
| PodMonitor, PrometheusRule | 4편 Prometheus가 지표를 모으고 지연·복제 경보를 냄 |
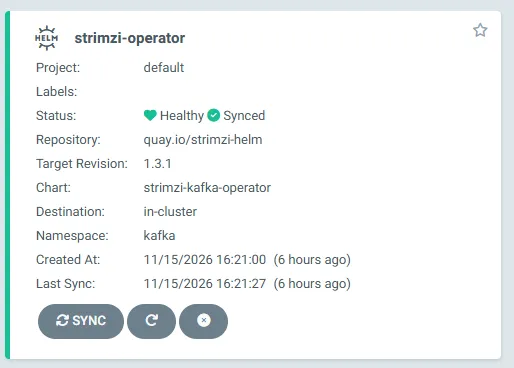
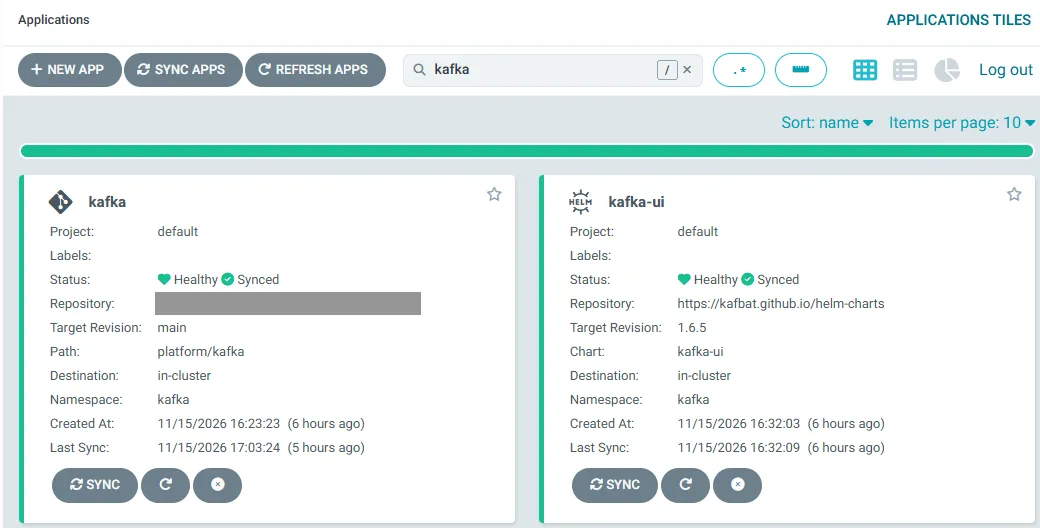
모두 9편의 GitOps 저장소에 커밋해서 설치했습니다. 위는 Strimzi 운영자, 아래는 Kafka 클러스터(Git 경로 platform/kafka)와 Kafka UI(Helm 차트) Application입니다.
설치 1: Strimzi 운영자
Strimzi 1.3.1(2026년 11월 4일 릴리스)은 쿠버네티스 1.32 이상을 지원하고, Kafka 4.2.2~4.3.2를 돌릴 수 있습니다. Kafka 4.x는 ZooKeeper 없이 KRaft 방식만 씁니다. Helm 차트는 OCI 저장소(quay.io/strimzi-helm)로 배포되어서, Argo CD에 OCI 저장소 Secret을 먼저 등록했습니다.
옛 예제 주의
Strimzi 1.0부터 CRD의 API 버전이
kafka.strimzi.io/v1하나만 남았습니다. 인터넷에 많은v1beta2예제는 그대로 적용되지 않으니, 설치한 버전 태그의examples/폴더를 기준으로 쓰는 편이 안전합니다.
# apps/03-strimzi-operator.yaml (일부)spec: sources: - repoURL: quay.io/strimzi-helm chart: strimzi-kafka-operator targetRevision: 1.3.1 helm: valueFiles: - $values/platform/strimzi/values.yaml destination: namespace: kafka syncPolicy: syncOptions: - CreateNamespace=true - ServerSideApply=true # CRD가 커서 클라이언트 쪽 apply로는 주석 크기 제한에 걸림---# platform/strimzi/values.yamldashboards: enabled: true # Strimzi Grafana 대시보드 9개를 ConfigMap으로 namespace: monitoring # 4편 Grafana 사이드카가 읽는 곳push부터 Synced Healthy까지 1분 31초 걸렸고, CRD 10개와 Grafana 대시보드 ConfigMap 9개가 생겼습니다. Grafana는 재시작 없이 대시보드를 읽어 들였습니다. 차트 서명은 이번에 확인하지 못했습니다. Strimzi 저장소에 cosign 공개 키가 없었고(404), 릴리스 자산의 SLSA 증명과 SBOM은 확인하지 않았습니다.
설치 2: Kafka 클러스터
로컬 PC라서 컨트롤러와 브로커를 따로 두지 않고, 둘을 겸하는(dual-role) 파드 3개를 만들었습니다. 노드 3개에 하나씩 가도록 podAntiAffinity를 걸었고, 하나는 제어 플레인 노드에 가야 해서 톨러레이션을 넣었습니다.
# platform/kafka/kafka.yaml (일부)apiVersion: kafka.strimzi.io/v1kind: KafkaNodePoolmetadata: name: dual labels: { strimzi.io/cluster: lab }spec: replicas: 3 roles: [controller, broker] storage: type: jbod volumes: - { id: 0, type: persistent-claim, size: 5Gi, deleteClaim: false, kraftMetadata: shared } resources: requests: { cpu: 200m, memory: 1Gi } limits: { memory: 1536Mi } jvmOptions: { "-Xms": 512m, "-Xmx": 768m }---apiVersion: kafka.strimzi.io/v1kind: Kafkametadata: name: labspec: kafka: version: 4.3.1 # 훈련 3에서 4.3.2로 올림 metadataVersion: 4.3-IV0 listeners: - name: tls # 클러스터 안에서만, TLS + 아이디·비밀번호(SCRAM) port: 9093 type: internal tls: true authentication: { type: scram-sha-512 } authorization: { type: simple } # ACL 사용 config: default.replication.factor: 3 min.insync.replicas: 2 # 복사본 3개 중 2개 이상에 적혀야 쓰기 성공 offsets.topic.replication.factor: 3 entityOperator: { topicOperator: {}, userOperator: {} } kafkaExporter: { topicRegex: ".*", groupRegex: ".*" }push부터 Kafka Ready까지 3분 38초 걸렸습니다. 처음 30초쯤은 디스크(PVC)를 기다리느라 Pending이었고, 브로커 3개가 뜬 뒤 Entity Operator와 Kafka Exporter가 차례로 올라왔습니다.
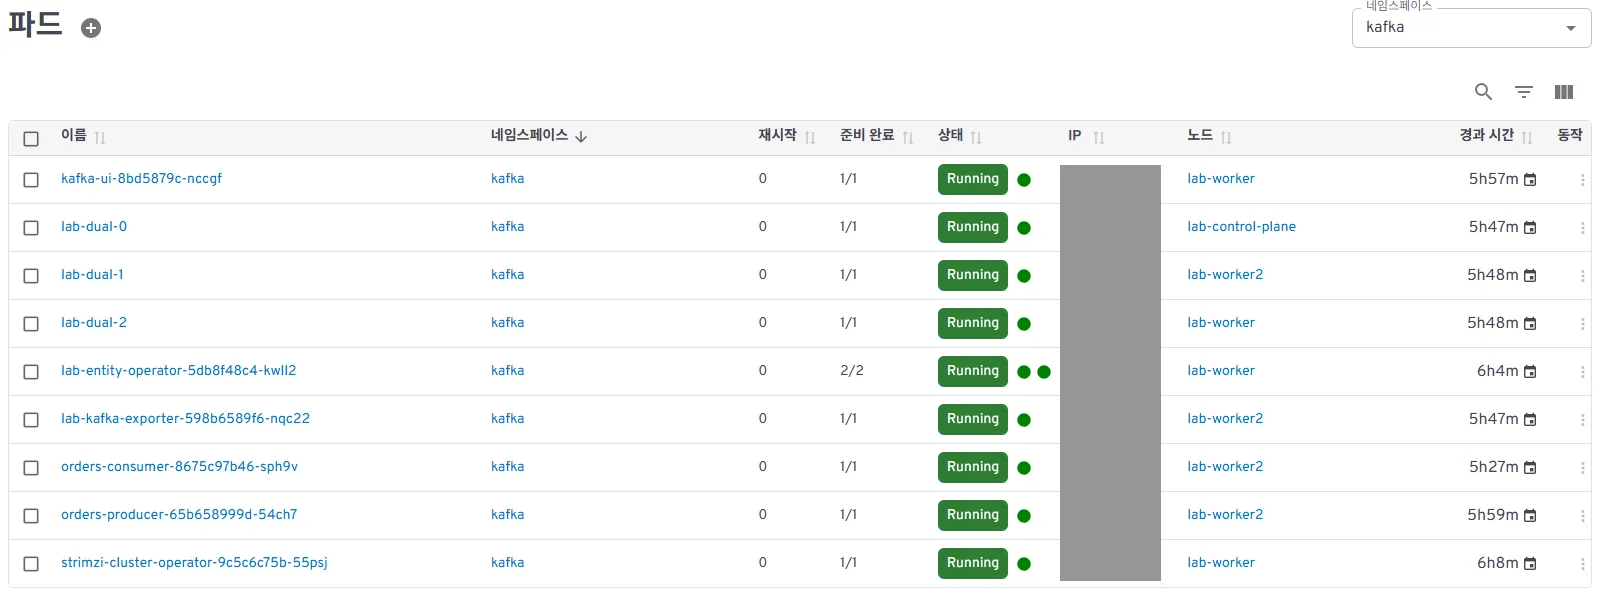
Headlamp에서 본 kafka 네임스페이스입니다. lab-dual-0~2가 서로 다른 노드에 하나씩 떠 있습니다. 화면의 파드 IP는 가렸습니다.
로컬 디스크는 노드에 묶인다
kind 기본 StorageClass(local-path)는 처음 파드가 뜬 노드의 디스크에 볼륨을 만들고, 그 볼륨을 그 노드에 묶습니다. 그래서 lab-dual-1은 앞으로도 lab-worker2에서만 뜰 수 있습니다. 이 성질이 훈련 2에서 문제가 됩니다.
토픽과 사용자: 누가 무엇을 할 수 있나
토픽과 계정도 YAML로 만들었습니다. 계정마다 할 수 있는 일을 ACL로 좁혀서, 생산자는 orders에 쓰기만, 소비자는 읽기만, Kafka UI는 보기만 하게 했습니다.
# platform/kafka/topics-users.yaml (일부)kind: KafkaTopicmetadata: name: ordersspec: partitions: 3 # 훈련 7에서 6, 9로 늘림 replicas: 3---kind: KafkaUsermetadata: name: producerspec: authentication: { type: scram-sha-512 } authorization: type: simple acls: - resource: { type: topic, name: orders, patternType: literal } operations: [Write, Describe]---kind: KafkaUsermetadata: name: consumerspec: authentication: { type: scram-sha-512 } authorization: type: simple acls: - resource: { type: topic, name: orders, patternType: literal } operations: [Read, Describe] - resource: { type: group, name: orders-consumer, patternType: literal } operations: [Read] # 이 이름의 소비자 그룹으로만 읽을 수 있음비밀번호는 Git에 없습니다. Strimzi의 User Operator가 계정마다 같은 이름의 Secret(producer, consumer, kafka-ui)을 만들고, 그 안에 비밀번호와 클라이언트가 바로 쓸 수 있는 sasl.jaas.config 값을 넣어 줍니다. 앱은 이 Secret을 환경 변수로 받아 씁니다.
훈련용 생산자와 소비자
훈련에 쓸 앱은 따로 만들지 않았습니다. Strimzi의 Kafka 이미지(quay.io/strimzi/kafka:1.3.1-kafka-4.3.1) 안에 있는 콘솔 도구를 그대로 썼습니다. 생산자는 결제 서버, 소비자는 배송·알림 같은 후속 서비스 역할이라고 보면 됩니다.
# platform/kafka/clients.yaml 생산자 명령(일부)# 1) Secret에서 받은 계정 정보로 접속 설정 파일을 만든다printf 'security.protocol=SASL_SSL\nsasl.mechanism=SCRAM-SHA-512\nsasl.jaas.config=%s\nssl.truststore.type=PEM\nssl.truststore.location=/ca/ca.crt\nacks=all\n' "$JAAS" > /tmp/client.properties# 2) 0.1초마다 "번호,보낸시각(ms)" 한 줄을 만들어 Kafka로 보낸다(초당 10건)i=0; while true; do echo "$i,$(date +%s%3N)"; i=$((i+1)); sleep 0.1; done | \  /opt/kafka/bin/kafka-console-producer.sh --bootstrap-server lab-kafka-bootstrap:9093 \    --topic orders --producer.config /tmp/client.properties
# 소비자 명령(일부): 그룹 orders-consumer로 읽어 파티션·오프셋과 함께 출력/opt/kafka/bin/kafka-console-consumer.sh --bootstrap-server lab-kafka-bootstrap:9093 --topic orders \  --group orders-consumer --consumer.config /tmp/client.properties \  --property print.partition=true --property print.offset=true
# 소비자 로그 한 줄: 파티션 2의 259번째 칸에 있던 259번 메시지Partition:2 Offset:259 259,1794727852559메시지에 진짜 주문 대신 번호를 넣은 이유는 세기 위해서입니다. 소비자가 받은 번호가 빠짐없이 이어지는지 보면 유실과 중복을 알 수 있고, 로그 시각이 비는 구간을 보면 소비가 몇 초 멈췄는지 알 수 있습니다. 훈련마다 이 계산을 하는 스크립트(kafka-lab/drill.sh)를 만들어, 동작 전후로 파티션 리더와 ISR, 파드 상태를 2초 간격으로 기록하게 했습니다.
Kafka 4.3의 옵션 이름 변경
Kafka 4.3 콘솔 도구에서는
--producer.config,--consumer.config를 쓰면--command-config를 쓰라는 경고가 나옵니다. 동작은 하지만 새 스크립트에는 새 옵션을 쓰는 편이 좋습니다.
Kafka UI로 화면에서 보기
Kafka UI(kafbat, 차트 1.6.5)는 kafka-ui 계정(읽기 전용 ACL)으로 붙고, 클러스터 설정도 readOnly: true로 두었습니다. 로그인 기능은 끄는 대신 Gateway로 열지 않고 kubectl port-forward로 이 PC에서만 열었습니다.
# platform/kafka-ui/values.yaml (일부)yamlApplicationConfig: auth: { type: disabled } kafka: clusters: - name: lab bootstrapServers: lab-kafka-bootstrap.kafka.svc:9093 readOnly: true properties: security.protocol: SASL_SSL sasl.mechanism: SCRAM-SHA-512 sasl.jaas.config: ${KAFKA_JAAS} # 아래 Secret에서 환경 변수로 ssl.truststore.type: PEM ssl.truststore.location: /ca/ca.crt # Strimzi 클러스터 CAenvs: secretMappings: KAFKA_JAAS: { name: kafka-ui, keyName: sasl.jaas.config }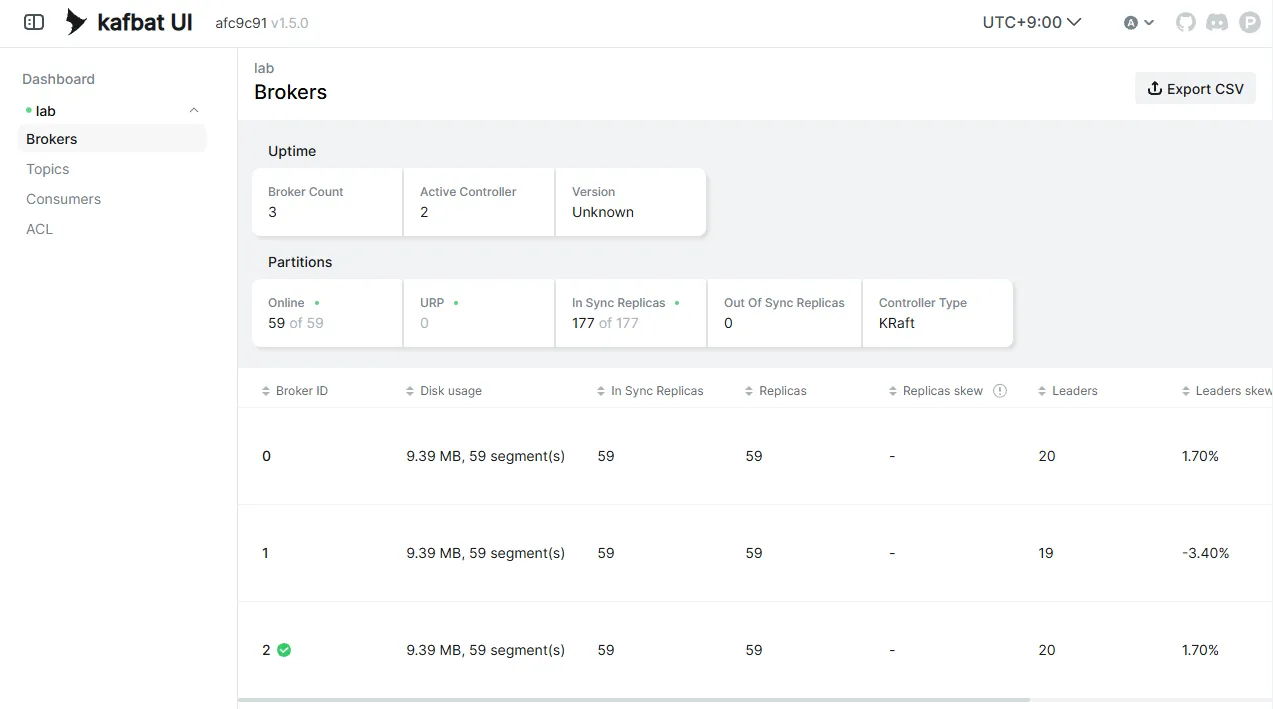
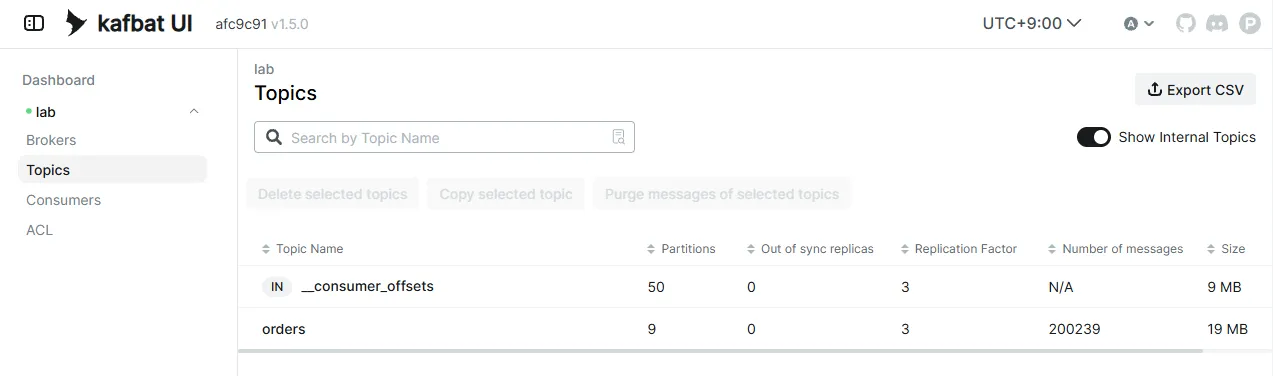
브로커 화면입니다. 숫자가 앞에서 본 개념과 그대로 맞아떨어집니다. 파티션 59개는 Kafka가 소비자 책갈피를 저장하는 내부 토픽 __consumer_offsets 50개와 orders 9개를 더한 값이고, 복사본 177개는 59 × 3입니다. 브로커마다 리더를 20, 19, 20개씩 나눠 맡고 있고, 복제가 덜 된 파티션(URP)은 0입니다. Version이 Unknown으로 나오는 것은 Kafka UI v1.5.0이 이 버전을 표시하지 못한 것으로, 실제 버전은 Kafka 리소스 상태에서 4.3.2로 확인했습니다.
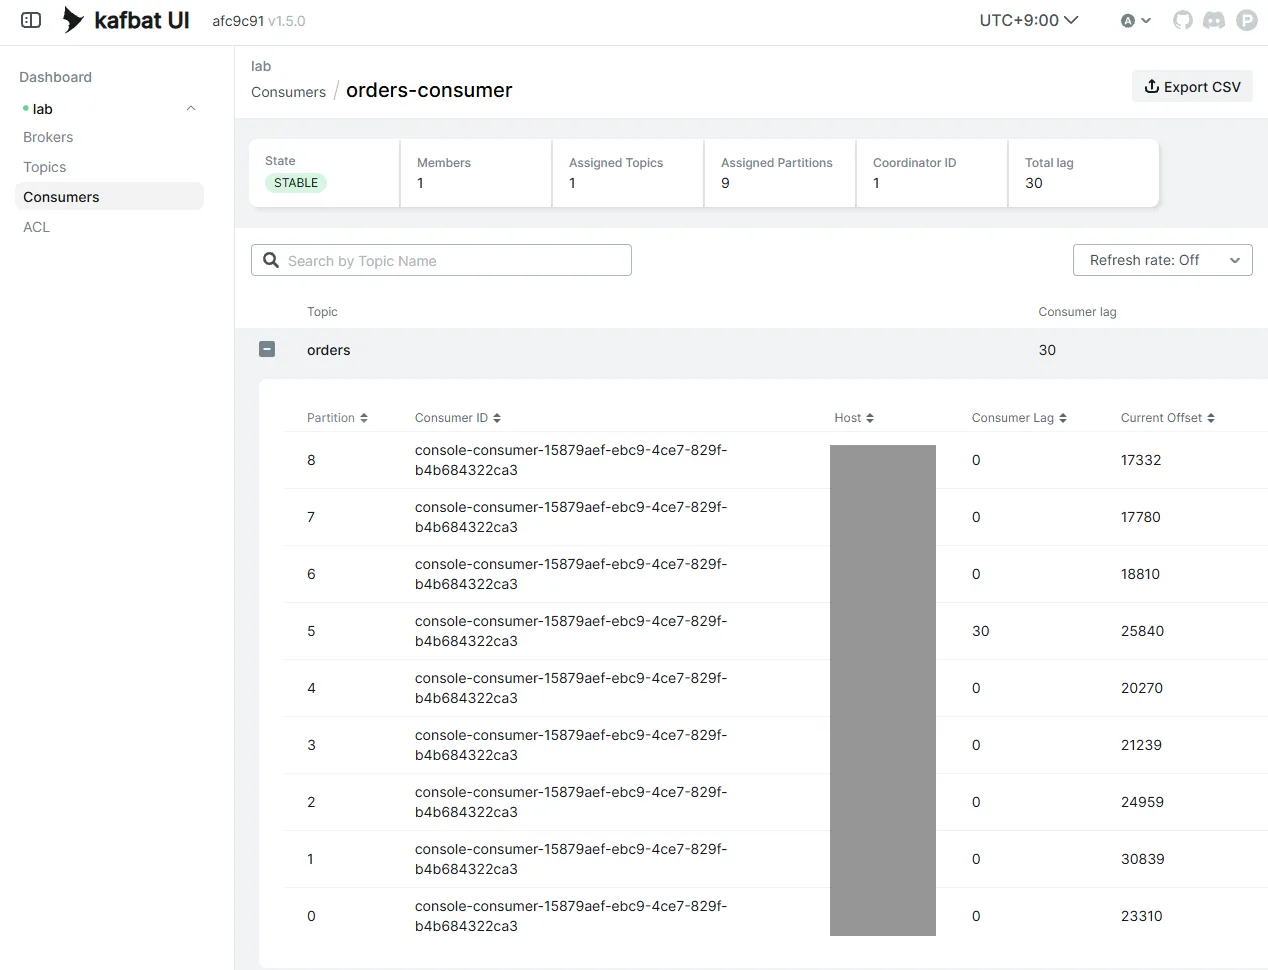
소비자 그룹 orders-consumer 화면입니다. 소비자 하나가 파티션 9개를 모두 맡고 있고, 파티션마다 책갈피(Current Offset)와 지연(Consumer Lag)이 보입니다. 찍는 순간 파티션 5에 막 들어온 30건이 지연으로 잡혔습니다. Host 열의 파드 IP는 가렸습니다.
지표와 경보
Strimzi 예제의 PodMonitor 3개에 4편 Prometheus가 찾는 라벨(release: kps)만 붙여 넣었습니다. 경보는 세 가지만 만들었습니다.
# platform/kafka/alerts.yaml (일부)- alert: KafkaConsumerLagHigh # 소비자 그룹이 500건 넘게 뒤처짐 expr: sum by (consumergroup, topic) (kafka_consumergroup_lag) > 500 for: 1m- alert: KafkaUnderReplicatedPartitions # 복제가 덜 된 파티션이 있음 expr: sum by (topic) (kafka_topic_partition_under_replicated_partition) > 0 for: 30s- alert: KafkaBrokerMissing # 지표를 보내는 브로커가 3대보다 적음 expr: count(kafka_server_replicamanager_leadercount) < 3 for: 30sStrimzi 차트가 넣어 준 Grafana 대시보드에서 훈련 시간대(16:30~17:10)를 보면 아래 훈련의 흔적이 그대로 남아 있습니다.
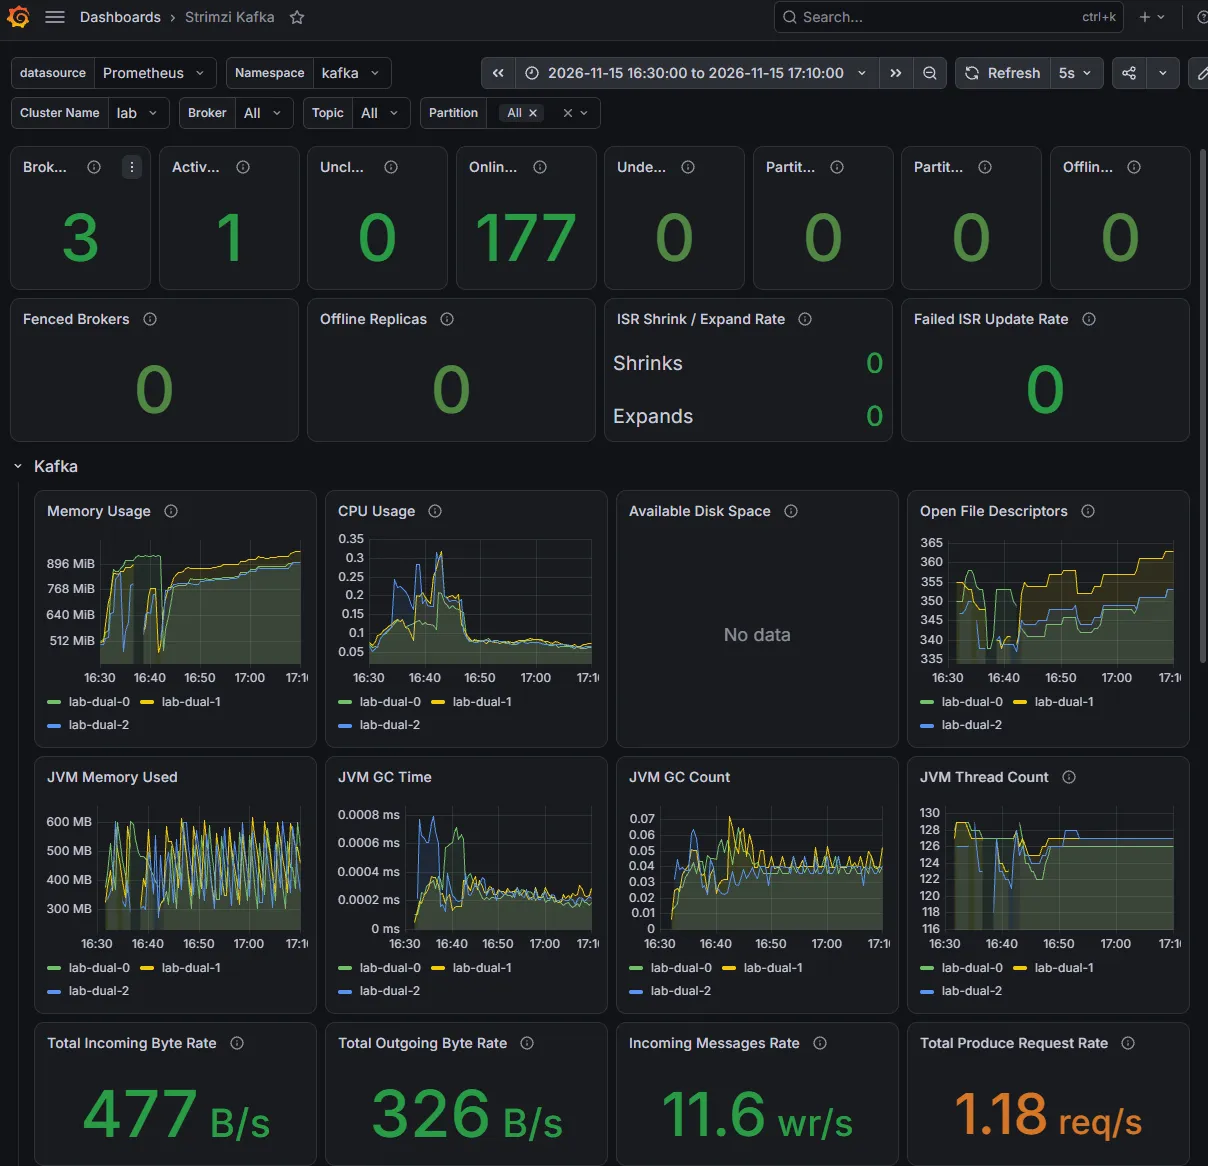
Strimzi Kafka 대시보드입니다. 16:34~16:42 사이 메모리 그래프가 끊겼다가 다시 오르는 것은 브로커 강제 종료와 재시작이고, 16:41 무렵 CPU가 0.3까지 튄 것은 롤링 업그레이드입니다. 위쪽 숫자 칸(브로커 3, 복제 부족 0)은 구간 끝의 값이라 훈련 순간은 보이지 않습니다.
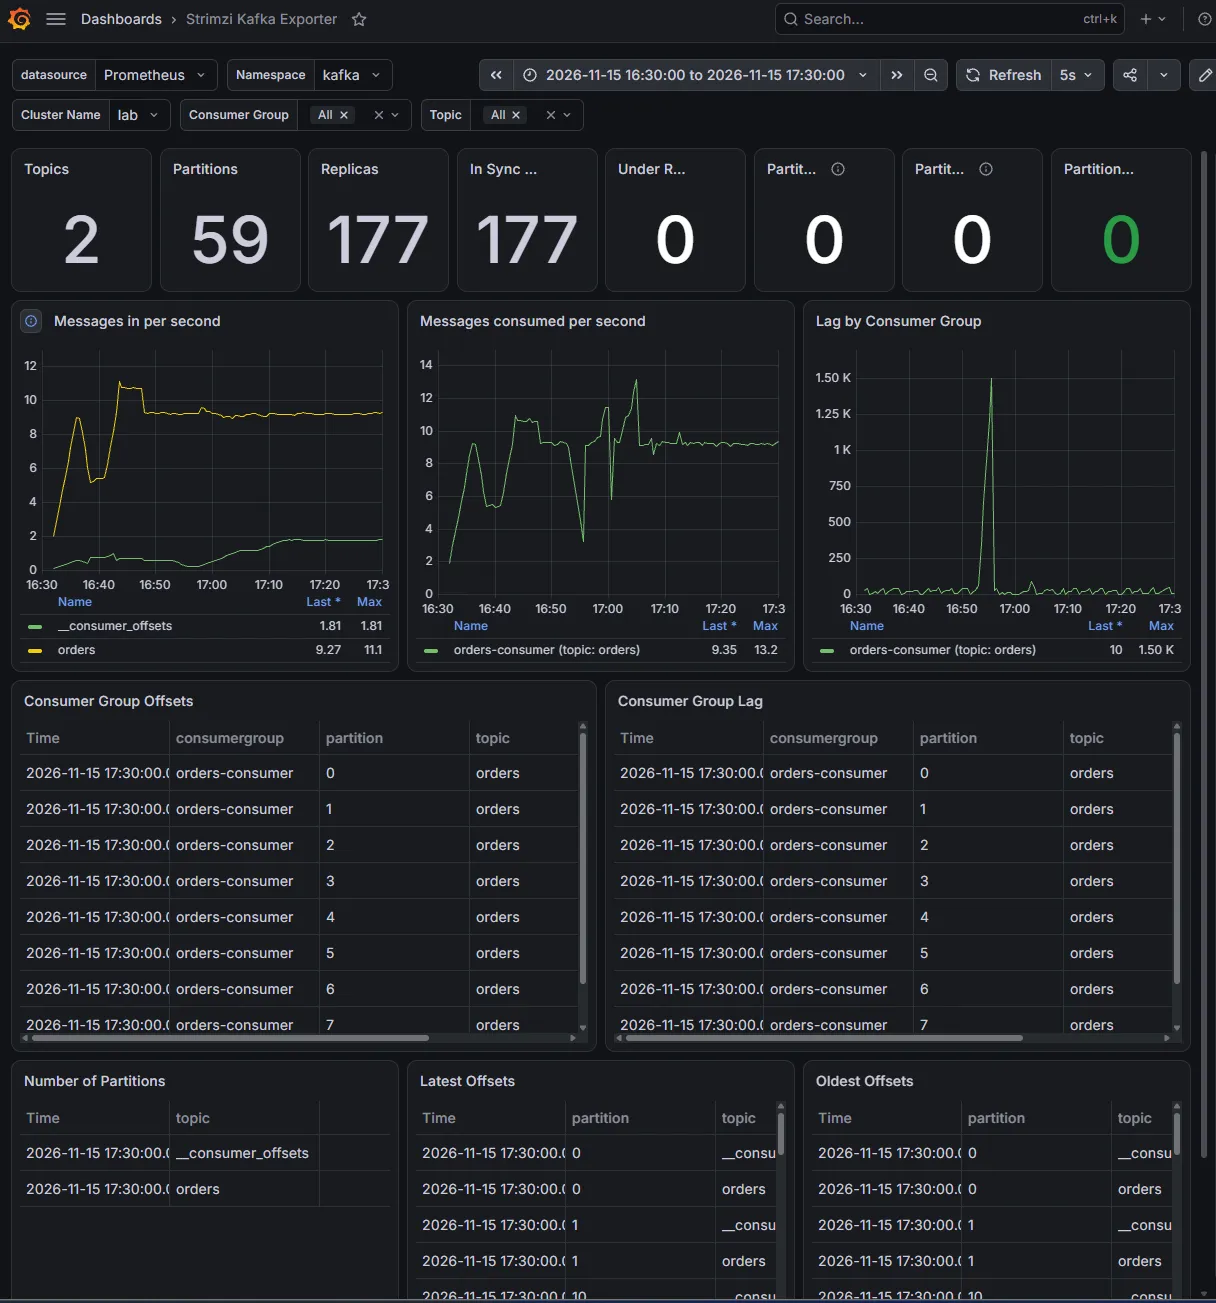
Strimzi Kafka Exporter 대시보드입니다. 오른쪽 위 Lag by Consumer Group이 16:55 무렵 약 1.5K까지 치솟았다가 바로 떨어지는 것이 훈련 4이고, 같은 시각 소비 속도(Messages consumed per second)가 3 가까이 떨어졌다가 13.2까지 튀는 것이 밀린 메시지를 따라잡는 모습입니다.
훈련 1: 리더 브로커를 강제로 죽이면
생산이 몰리던 파티션 orders-2의 리더는 브로커 2였습니다. 이 파드를 대기 시간 없이 강제로 지웠습니다.
kubectl -n kafka delete pod lab-dual-2 --grace-period=0 --force16:34:03 lab-dual-2 강제 삭제16:34:04 orders-2의 ISR 3 → 2, Strimzi가 새 파드를 바로 만듦16:34:07 orders-2의 리더 브로커 2 → 0 (약 3초)16:34:18 모든 파티션 ISR 3으로 회복16:34:29 새 파드 Ready생산자 오류는 0건이었고, 이 구간에 소비자가 받은 1,120건(번호 1900~3019)은 빠짐과 중복이 모두 0이었습니다. 생산자는 리더가 바뀐 것을 메타데이터로 알아채고 새 리더로 보냈습니다. 브로커가 돌아온 뒤에도 리더는 브로커 0에 남아 있었습니다.
훈련 2: 브로커 2대가 멈추고, 노드에 묶인 디스크 때문에 못 돌아오면
이번에는 브로커 3대 중 2대를 멈추고, 그 파드들이 다시 뜰 노드도 막았습니다(cordon). 실제로는 노드 두 대가 한꺼번에 문제가 생긴 상황입니다.
kubectl cordon lab-worker lab-worker2kubectl -n kafka delete pod lab-dual-1 lab-dual-2 --grace-period=0 --force두 파드는 다른 노드로 옮겨 가지 못하고 Pending에 머물렀습니다. 남은 노드(제어 플레인)는 이미 lab-dual-0이 쓰고 있고, 무엇보다 각 파드의 볼륨이 원래 노드에 묶여 있기 때문입니다.
0/3 nodes are available: 1 node(s) didn't match PersistentVolume's node affinity,1 node(s) had untolerated taint(s), 1 node(s) were unschedulableISR이 1개(브로커 0)만 남자 Kafka는 쓰기를 거절했습니다. min.insync.replicas: 2이므로 복사본 2곳에 적을 수 없으면 받지 않는 것입니다.
NotEnoughReplicasException: Messages are rejected since there are fewer in-sync replicas than required.훈련 2 결과
| 항목 | 값 |
|---|---|
| 생산자 오류 | NotEnoughReplicas 1,067건 + OutOfOrderSequence 10건 = 1,077건 |
| 소비자 기준 유실 | 1,077건(번호 3210~5466 사이), 중복 0 |
| 소비가 멈춘 시간 | 115.5초(16:37:59 uncordon → 16:38:01 파드 Running → 16:38:22 ISR 회복 → 소비 재개) |
Kafka는 데이터를 지키려고 받지 않았는데, 결과적으로 메시지는 사라졌습니다. 콘솔 생산자가 재시도 3번 만에 포기하고 그 메시지를 버렸기 때문입니다. 유실 건수가 생산자 오류 건수와 정확히 같습니다. 실제 서비스라면 생산자의 재시도 시간(delivery.timeout.ms)을 충분히 두고, 그래도 실패한 메시지는 DB 같은 곳에 남겨 다시 보내야 합니다.
노드에 묶인 볼륨
노드가 영영 돌아오지 않으면 그 노드의 볼륨을 쓰던 브로커도 돌아오지 못합니다. 클라우드에서는 네트워크 디스크(EBS 등)를 쓰더라도 가용 영역(AZ)에 묶이므로, 브로커를 AZ마다 나눠 두고 복제 3에 min.insync 2를 쓰는 이유가 이것입니다.
훈련 3: Kafka 4.3.1 → 4.3.2 롤링 업그레이드
Git에서 version: 4.3.1을 4.3.2로 한 줄 바꿔 push했습니다. 나머지는 Strimzi가 알아서 합니다.
16:40:42 push(kafka.yaml version: 4.3.2)16:41:02 lab-dual-1 재시작 → 16:41:05 새 파드16:41:25 lab-dual-2 재시작 → 16:41:41 Running16:42:01 lab-dual-0 재시작(리더를 다른 브로커로 옮긴 뒤) → 16:42:35 Ready16:42:38 모든 파티션 ISR 3으로 회복한 번에 한 대씩, 앞 브로커의 복제가 따라잡은 것을 확인하고 다음으로 넘어갔습니다. 첫 재시작부터 끝까지 1분 36초였습니다. 생산자 쪽에는 리더가 바뀌었다는 경고(NotLeaderOrFollower) 2건과 재시도 2건만 남았고 모두 성공했습니다. 소비자가 받은 6,120건(번호 5707~11826)은 빠짐과 중복이 0이었습니다.
훈련 2와 비교하면 차이가 분명합니다. 사람이 두 대를 한꺼번에 내리면 메시지가 빠지지만, 운영자가 한 대씩 상태를 보며 내리면 min.insync 2가 지켜져서 아무것도 빠지지 않습니다.
훈련 4: 소비자가 멈추면 경보가 울리고, 다시 켜면 따라잡는다
소비자 Deployment의 replicas를 Git에서 0으로 바꿨습니다. 생산은 계속되니 지연이 10초에 약 100건씩 쌓입니다.
16:52:12 push(소비자 replicas: 0)16:53:21 지연 49016:53:54 KafkaConsumerLagHigh pending (500을 넘은 직후)16:55:01 KafkaConsumerLagHigh firing (1,420건, push부터 2분 49초)16:55:15 push(소비자 replicas: 1)16:55:28 소비자 Ready, 지연 1,66016:55:38 지연 10 ← 밀린 약 1,660건을 10초 안에 처리16:56:01 경보 해제(push부터 46초)메시지는 그대로 Kafka에 남아 있었고, 소비자는 책갈피부터 이어 읽어 하나도 빠뜨리지 않았습니다. 앞에서 말한 “받는 쪽이 죽어 있어도 살아나면 이어서 처리한다”가 바로 이 장면입니다. 경보가 firing까지 약 1분 걸린 것은 for: 1m 때문이니, 실제 서비스에서는 지연 건수와 함께 “지연이 몇 분째 줄지 않는가”를 보는 편이 좋습니다.
훈련 5: 권한(ACL) 밖의 일을 시키면
실행 중인 생산자·소비자 파드에 들어가, 각 계정으로 권한 밖의 일을 시도했습니다. 네 경우 모두 거절됐습니다.
ACL 거절 결과
| 시도 | 결과 |
|---|---|
| consumer 계정으로 orders에 쓰기 | ClusterAuthorizationException: Cluster authorization failed. |
| producer 계정으로 읽기(그룹 acl-test) | GroupAuthorizationException: Not authorized to access group: acl-test |
| consumer 계정, 허용 안 된 그룹 이름(other-group) | GroupAuthorizationException |
| consumer 계정으로 토픽 만들기 | TopicAuthorizationException: Authorization failed. |
첫 번째가 예상과 달랐습니다. 토픽 쓰기 권한이 없다는 오류가 나올 줄 알았는데 클러스터 권한 오류가 먼저 나왔습니다. Kafka 생산자는 기본으로 멱등(같은 메시지를 두 번 써도 한 번만 남게 하는) 모드로 동작하고, 이 모드는 시작할 때 클러스터 쪽 권한을 먼저 확인하기 때문입니다. 오류 메시지만 보고 클러스터 권한을 주면 안 되고, 실제로 빠진 것이 토픽 Write 권한인지 확인해야 합니다.
훈련 7: 파티션을 늘렸더니 오류 없이 1,000건이 사라졌다
처리량을 늘리려면 소비자를 늘리고, 소비자 수가 파티션 수에 닿으면 파티션을 늘려야 합니다. orders의 partitions를 3에서 6으로 바꿔 push했습니다. 19초 만에 브로커에 파티션 6개가 생겼고, 생산자 오류는 0건이었습니다. 그런데 소비자 기준으로 1,000건이 빠졌고, 소비가 54초씩 두 번 멈췄습니다.
파티션 4: 끝 오프셋 500, 소비자 그룹 책갈피 500 ← 0~499를 읽지 않고 끝에 책갈피파티션 5: 끝 오프셋 500, 소비자 그룹 책갈피 500 ← 마찬가지메시지는 Kafka에 그대로 있었습니다. 소비자가 읽지 않고 건너뛴 것입니다. 순서는 이랬습니다.
- 생산자는 새 파티션을 금방 알아채고, 한동안 파티션 4에 몰아서 썼습니다(키 없는 메시지는 한 파티션에 묶어 보내다가 옮겨 가는 방식).
- 소비자는 아직 새 파티션을 배정받지 못해 그 메시지를 읽지 못했습니다. 이것이 54초 멈춤입니다.
- 나중에 배정을 받았을 때 이 파티션에는 책갈피가 없었습니다. 책갈피가 없으면
auto.offset.reset설정을 따르는데, 기본값이 latest(지금 끝부터)입니다. - 그래서 이미 쌓인 500건을 건너뛰고 끝에 책갈피를 꽂았습니다. 파티션 5에서도 같은 일이 반복됐습니다.
대책은 소비자에 auto.offset.reset=earliest를 주는 것입니다. 책갈피가 없는 파티션은 남아 있는 처음부터 읽게 됩니다.
# platform/kafka/clients.yaml 소비자 명령에 추가 --consumer-property auto.offset.reset=earliest이렇게 바꾼 뒤 파티션을 6에서 9로 늘렸습니다. 6분 동안 받은 3,530건(번호 18247~21776)은 빠짐과 중복이 0이었고, 새 파티션 6도 처음부터 읽었습니다. 다만 소비가 35.5초 멈추는 것은 그대로였습니다. earliest는 유실을 막아 줄 뿐이고, 새 파티션을 알아채고 다시 나누는 데 걸리는 시간은 남습니다. 지연이 중요한 서비스라면 파티션은 미리 넉넉히 만들어 두는 편이 낫습니다.
이 설정을 바꾸다 겪은 일
이 한 줄을 넣으면서 sed로 YAML을 고쳤다가, 줄바꿈 문자가 글자 그대로 들어가고 주석이 bash 줄 잇기 안에 들어가 소비자 명령이 깨진 채로 push됐습니다. 20초 뒤 고쳐서 다시 push했고 소비자가 정상으로 다시 뜬 것을 확인했습니다. 여러 줄짜리 명령이 든 YAML은 편집기로 고치고, push 전에
kubectl apply --dry-run=server로 확인하는 편이 안전합니다.
정리: 메시지는 어디서 빠지나
훈련 결과를 “어디서 빠졌나” 기준으로 다시 모으면 다음과 같습니다. Kafka 자체가 메시지를 잃은 경우는 없었고, 빠진 두 번은 모두 클라이언트 쪽 설정 문제였습니다.
훈련별 유실과 멈춤
| 훈련 | 유실 | 소비 멈춤 | 핵심 |
|---|---|---|---|
| 1. 리더 브로커 종료 | 0 | 최대 2.2초 | 복제 3 + min.insync 2로 리더가 바로 넘어감 |
| 2. 브로커 2대 정지 | 1,077건 | 115.5초 | Kafka는 거절, 생산자가 재시도 끝에 버림 |
| 3. 롤링 업그레이드 | 0 | 2.5초 이하 | Strimzi가 한 대씩 ISR을 보며 재시작 |
| 4. 소비자 정지 | 0 | 소비자를 끈 동안 | 책갈피부터 이어 읽어 1,660건을 10초에 처리 |
| 7. 파티션 3 → 6 | 1,000건 | 약 54초 × 2 | 새 파티션에서 latest로 시작해 건너뜀 |
| 7-2. 파티션 6 → 9(earliest) | 0 | 35.5초 | 유실은 막았지만 재배정 시간은 남음 |
유실을 막는 설정
| 위치 | 설정 |
|---|---|
| Kafka(브로커·토픽) | 복제 3, min.insync.replicas 2, 브로커를 노드·AZ마다 나눠 배치 |
| 보내는 쪽 | acks=all, 충분한 재시도 시간(delivery.timeout.ms), 끝내 실패한 메시지는 따로 보관해 다시 보내기 |
| 받는 쪽 | auto.offset.reset=earliest, 처리를 끝낸 뒤 책갈피 기록, 같은 메시지를 두 번 받아도 괜찮게(멱등 처리) |
| 운영 | 지연 경보, 복제 부족 경보, 파티션을 늘린 뒤 소비자 지연과 누락 확인 |
AWS MSK에서는 어떤 지표를 보나
AWS의 관리형 Kafka인 Amazon MSK는 브로커 관리를 AWS가 맡고, 상태를 CloudWatch 지표로 보여 줍니다. 1분 간격으로 들어오고, DEFAULT 수준 지표는 무료입니다. 이번 실습의 경보와 대응되는 지표를 MSK 지표 문서 기준으로 정리했습니다.
실습 경보와 MSK 지표 대응
| 이번 실습 | MSK CloudWatch 지표 | 정상 |
|---|---|---|
| KafkaConsumerLagHigh(지연 합 > 500) | SumOffsetLag, MaxOffsetLag, EstimatedMaxTimeLag(다 읽는 데 걸릴 예상 초) | 줄어들거나 일정 |
| KafkaUnderReplicatedPartitions | UnderReplicatedPartitions | 0 |
| (훈련 2의 쓰기 거절 상태) | UnderMinIsrPartitionCount | 0 |
| Grafana Offline 칸 | OfflinePartitionsCount(리더 없는 파티션) | 0 |
| KafkaBrokerMissing | 브로커별 LeaderCount가 들어오는지 | 브로커마다 비슷 |
| 디스크 | KafkaDataLogsDiskUsed(데이터 디스크 %) | 여유 있게 |
MSK 알람을 볼 때 헷갈리기 쉬운 점이 몇 가지 있습니다. 첫째, 지연 지표가 커지는 것은 “소비자가 늦다”는 뜻이지 데이터가 없어졌다는 뜻이 아닙니다. 훈련 4처럼 소비자가 살아나면 따라잡습니다. 다만 지연 시간이 토픽 보관 기간에 가까워지면 읽기 전에 메시지가 지워지므로 그때는 실제 유실이 됩니다. 둘째, MSK 문서에 따르면 소비자 그룹이 STABLE이나 EMPTY 상태가 아니거나(리밸런스 중), 그룹 이름에 콜론이나 ASCII가 아닌 문자(예: 한글)가 있거나, 오프셋을 한 번도 커밋하지 않았으면 지연 지표가 아예 나오지 않습니다. “데이터 누락” 알람이 지표가 들어오지 않은 것을 뜻하는 경우가 많습니다. 셋째, NetworkRxDropped와 NetworkTxDropped는 브로커 네트워크에서 버려진 패킷 수이지 Kafka 메시지 수가 아닙니다.
운영 체크리스트
- 토픽은 복제 3,
min.insync.replicas2로 만들고, 브로커는 노드(클라우드에서는 AZ)마다 나눠 둔다. - 로컬 디스크(local-path)는 노드에 묶인다. 노드가 돌아오지 않으면 그 브로커도 돌아오지 않는다.
- 생산자는
acks=all과 충분한 재시도 시간을 쓰고, 끝내 실패한 메시지를 버리지 않게 한다(훈련 2). - 소비자는
auto.offset.reset=earliest를 기본으로 하고, 처리를 끝낸 뒤 오프셋을 커밋한다(훈련 7). - 파티션은 늘릴 수만 있고 줄일 수 없다. 늘리면 키별 파티션 배치가 바뀌고 소비가 잠시 멈추니 미리 넉넉히 잡는다.
- 업그레이드와 설정 변경은 Strimzi에 맡겨 한 대씩 재시작하게 한다. 사람이 여러 대를 한꺼번에 내리지 않는다(훈련 2와 3의 차이).
- 소비 지연, 복제 부족, 브로커 수에 경보를 건다. 지연 경보는 건수와 함께 지속 시간도 본다.
- 계정은 용도별로 나누고 ACL을 좁게 준다. 클러스터 권한 오류가 나도 먼저 토픽 권한이 맞는지 본다(훈련 5).
- Strimzi 1.x는 CRD
v1만 쓴다. 옛v1beta2예제를 그대로 쓰지 않는다.
자주 묻는 질문
Kafka와 RabbitMQ 같은 메시지 큐는 무엇이 다른가요?
가장 큰 차이는 읽어도 지워지지 않는다는 점입니다. Kafka는 보관 기간까지 메시지를 남겨 두므로 여러 그룹이 같은 메시지를 각자 읽을 수 있고, 버그를 고친 뒤 과거 메시지부터 다시 처리할 수도 있습니다. 대신 브로커, 디스크, 복제를 운영해야 해서 다루기는 더 무겁습니다.
파티션은 몇 개로 잡아야 하나요?
한 소비자 그룹 안에서 파티션 하나는 소비자 하나만 읽으므로, 파티션 수가 동시에 일할 수 있는 소비자 수의 상한입니다. 앞으로 늘릴 소비자 수를 생각해 미리 넉넉히 잡는 편이 좋습니다. 훈련 7처럼 나중에 늘리면 소비가 잠시 멈추고, 설정에 따라 메시지를 건너뛸 수 있습니다.
브로커가 3대인데 왜 2대만 죽어도 쓰기가 막히나요?
`min.insync.replicas`를 2로 두었기 때문입니다. 복사본 2곳 이상에 적을 수 있을 때만 쓰기를 받겠다는 뜻이라, 1대만 남으면 데이터를 잃지 않으려고 거절합니다. 1대로도 받게 하면 그 1대가 죽는 순간 메시지를 잃을 수 있습니다.
Strimzi 없이 Helm 차트나 StatefulSet으로 Kafka를 올리면 안 되나요?
올릴 수는 있지만 인증서, 계정, ACL, 한 대씩 하는 업그레이드, 설정 변경 시 재시작 순서를 직접 챙겨야 합니다. 이번 훈련 3처럼 버전 한 줄만 바꾸면 운영자가 순서대로 처리해 주는 것이 Strimzi를 쓰는 이유입니다. 클라우드에서는 MSK 같은 관리형 서비스도 선택지입니다.
작성 방식과 다음 편
이 글에 나온 명령, 오류 메시지, 측정값은 모두 1편의 실습 PC에서 직접 실행한 결과이고, 설정은 Strimzi 1.3.1 예제와 공식 문서, Kafka UI 차트, AWS MSK 문서를 기준으로 했습니다. 앱 코드 예시는 이해를 돕기 위한 것이고 실행하지 않았습니다. 화면에 보이던 저장소 주소와 IP는 가렸고, 실행 기록을 정리하고 글을 쓰는 데 AI 도구를 함께 썼습니다. 이번에 경보로 쓴 소비 지연 지표는 뒤의 KEDA 편에서 소비자 파드 수를 자동으로 늘리는 기준으로 다시 씁니다.